Daten zeigen, wo Menschen abspringen. Das Warum nie.
Wie wir ein Jahr Finanzierungsnews und 100 arabische Websites auswerteten, was die Zahlen belegen, was nicht, und wie Datenanalyse als Designmethode gelingt.
Auf dieser Seite
- Das Wichtigste
- Was ist Datenanalyse in der UX-Forschung?
- Warum zählen statt fragen?
- Wie haben wir gewählt, was wir lesen?
- Was hat der Scanner tatsächlich geprüft?
- Warum trägt jede Zahl ihre Basis?
- Passt die Stichprobe zum Ergebnis?
- Was haben die Daten tatsächlich gezeigt?
- Wo hören die Daten auf?
- Wie lesen Sie den Absprung im eigenen Produkt?
- Was tun Sie mit dem Warum?
- Wie nutzen Sie KI für Datenanalyse, ohne sich selbst zu täuschen?
- Wann sollten Sie nicht mit Daten beginnen?
- Wie sieht das beim nächsten Mal aus?
- Häufige Fragen
- Quellen
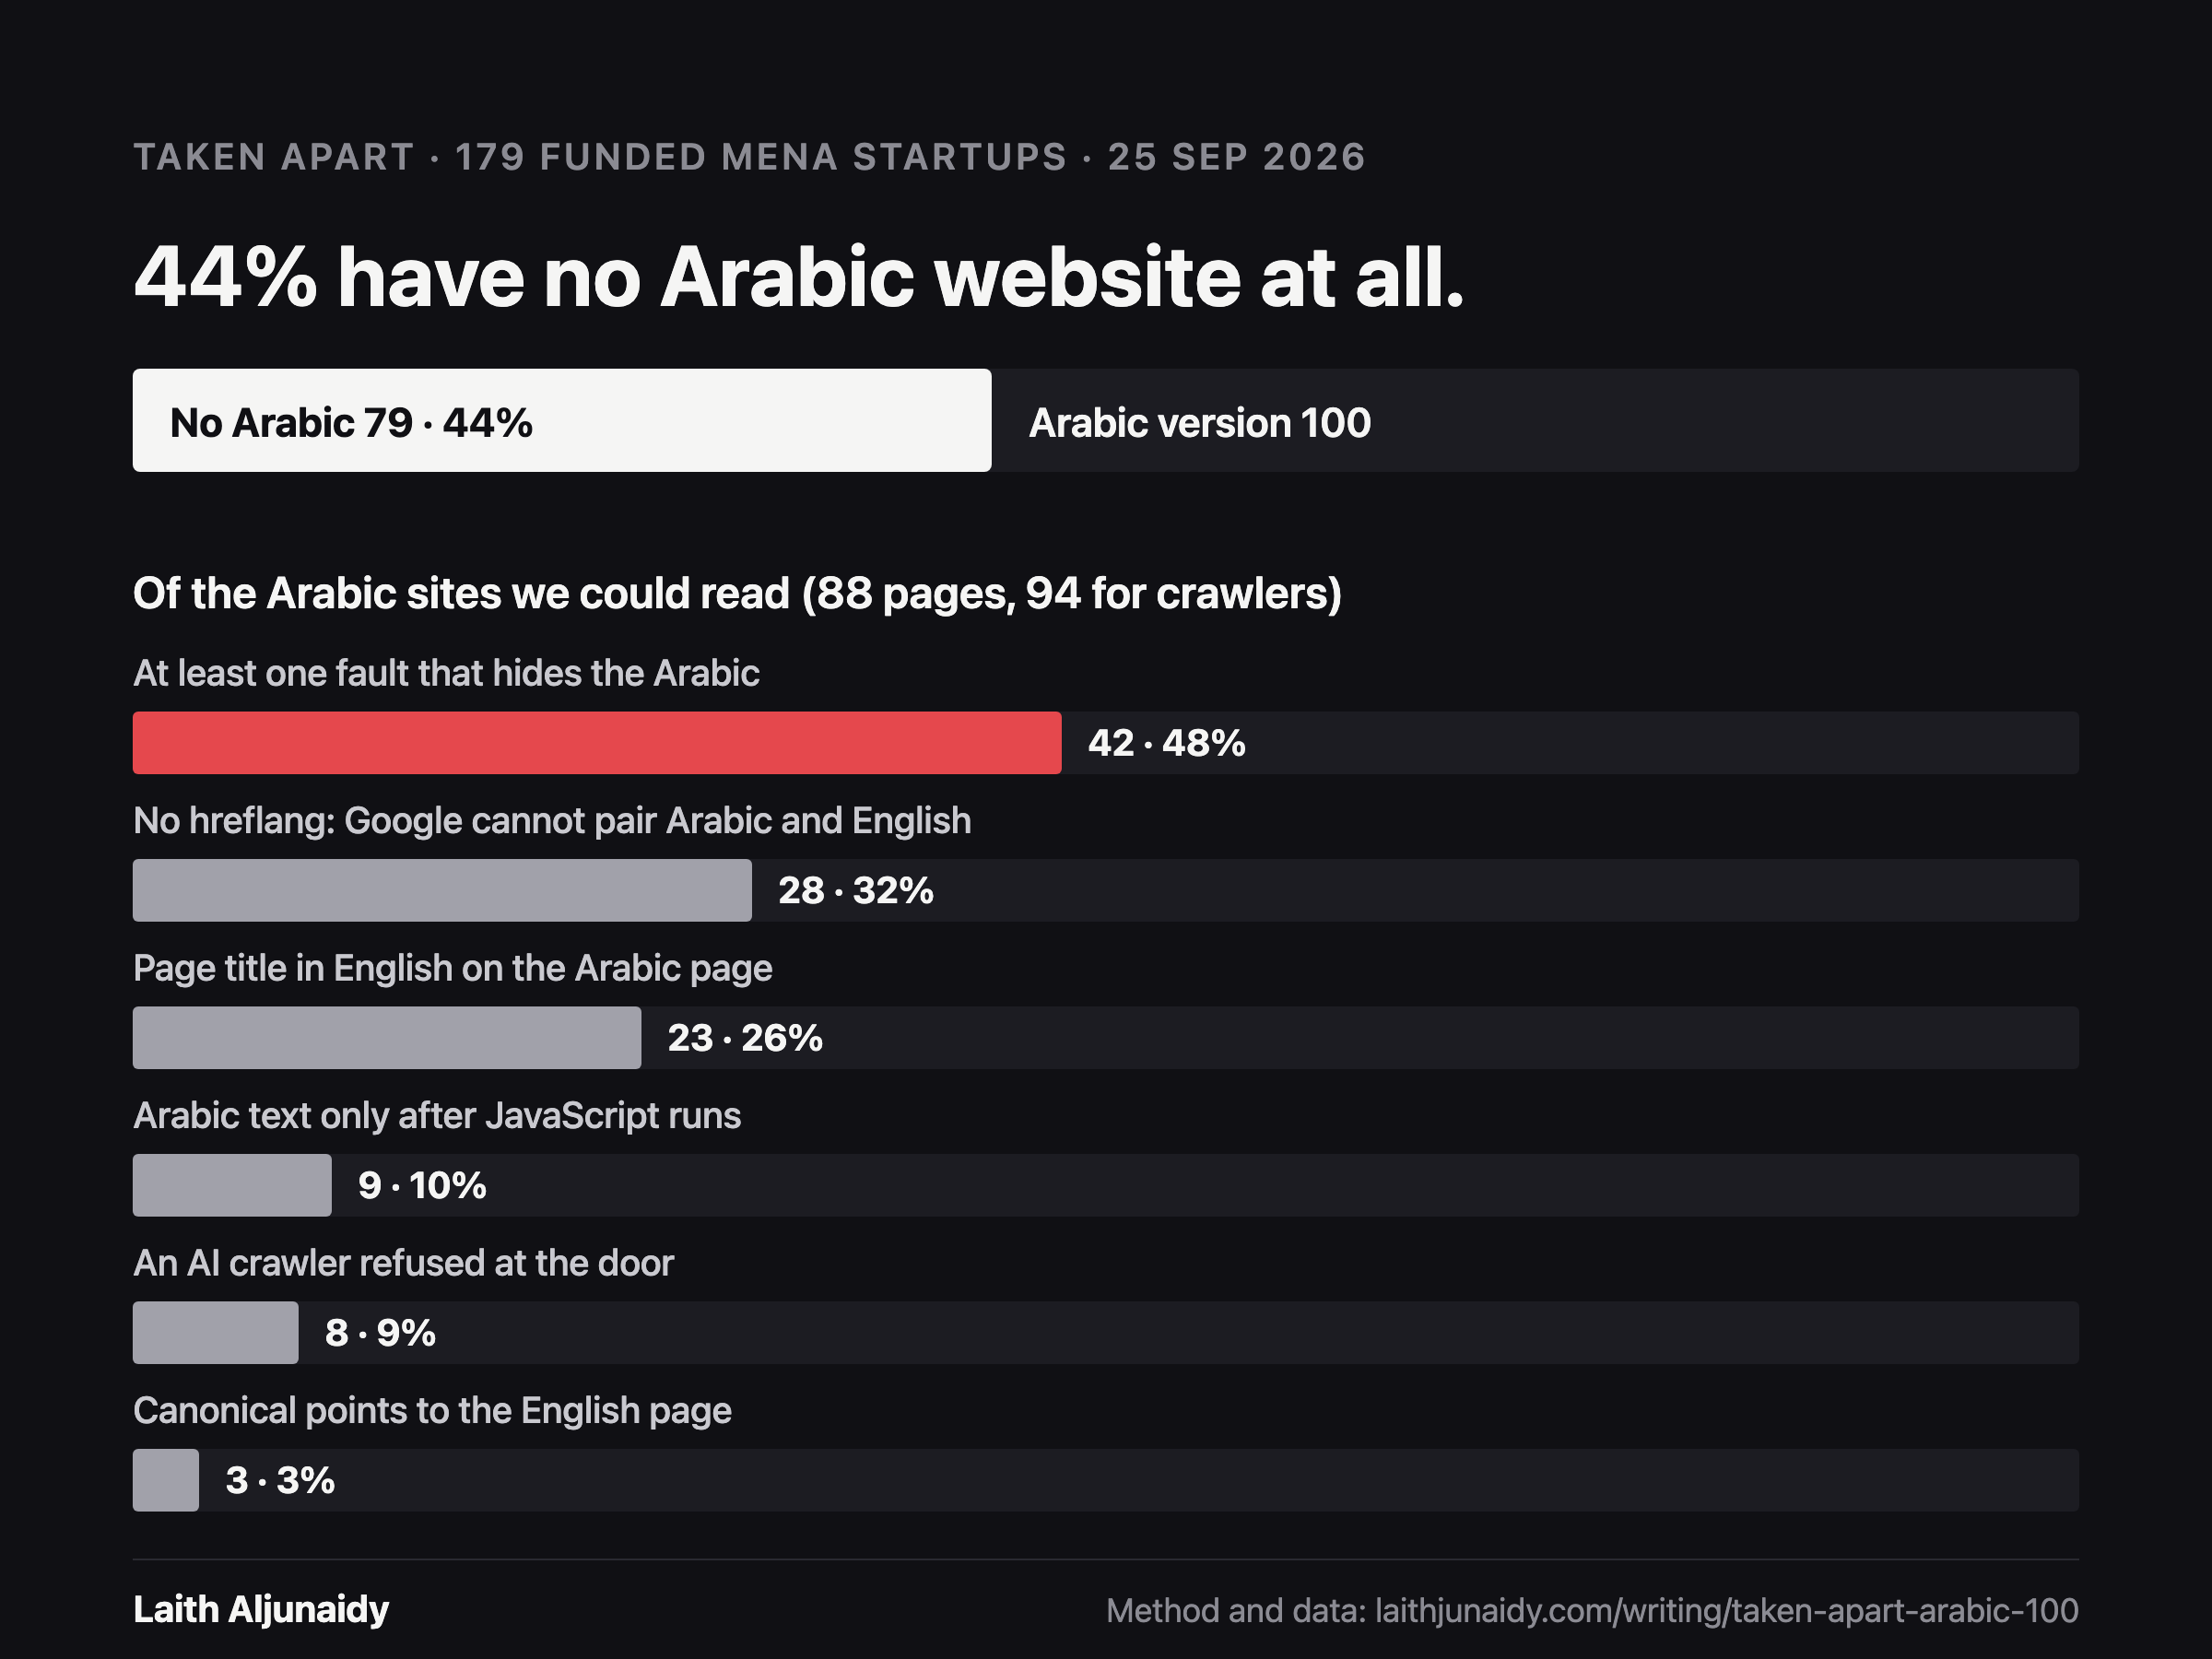
Am 25. September 2026 habe ich Taken apart, Nummer zwei veröffentlicht. Von 179 finanzierten Startups der Region mit einer prüfbaren Website hatten 79 gar keine arabische Version. Das sind 44 Prozent.
Jeder Gründer der Region sagt zum Arabischen dasselbe: Natürlich unterstützen wir es. Ich wollte wissen, was das auf der Seite bedeutet, also hörte ich auf zu fragen und zählte. Eine öffentliche Liste, der Reihe nach gelesen, jedes Unternehmen geprüft, keine Auswahl. Der Commit, der das Ergebnis veröffentlichte, nennt Claude als Co-Autor. Der Scanner, die Stichprobe und die Notizen dazu, wie die Stichprobe gezogen wurde, gingen neben dem Essay online, offen für jeden, der sie neu laufen lassen will.
Die Zahl ist jetzt das Beispiel unter Datenanalyse in meinem Leitfaden zum Designprozess. Liest man sie ein zweites Mal, steckt die Grenze schon im Ergebnis. Die Daten sagen, dass 53 von 67 finanzierten Startups aus den VAE sich nur auf Englisch präsentieren. Zum Warum sagen sie kein Wort. Nicht, ob die Gründer es entschieden, vergessen, nicht bezahlen konnten oder nie dachten, dass ihre Käufer Arabisch lesen. Jeder Grund, den ich nennen könnte, wäre eine Vermutung im Gewand eines Befunds.
Diese Lücke ist die ganze Methode. Datenanalyse sagt Ihnen, wo Menschen abspringen. Das Warum sagt sie nie. So wurde der Scan tatsächlich gebaut und gelesen, und das lehrt er über den Einsatz von Daten im Design.
Das Wichtigste
- Datenanalyse heißt, zu lesen, was bereits existiert, bevor Sie etwas Neues machen: Analytics, Verkäufe, Support-Tickets, Suchprotokolle, App-Bewertungen, öffentliche Daten, alte Forschung. Es ist die billigste Forschung, die es gibt, also kommt sie zuerst.
- Sie beantwortet Wo und Wie viele. Das Warum beantwortet sie nicht. Das Warum kommt aus Interviews und aus dem Beobachten von Menschen, und die Daten sagen Ihnen, wen Sie fragen und wonach.
- Legen Sie Quelle und Reihenfolge fest, bevor Sie hinsehen. Wir lasen die Finanzierungsnews von Wamda von neu nach alt und prüften jedes passende Unternehmen der Reihe nach. Nichts wurde gewählt, weil es Probleme hatte.
- Jede Zahl trägt ihre Basis. Dieselben 79 Unternehmen sind 44 Prozent von 179 und 43 Prozent von 184. Beides stimmt. Nur eines ist ohne Nenner ehrlich.
- Gemessen, nie geraten. Eine Seite, die nicht gelesen werden konnte, blieb aus dieser Prüfung draußen, und das wurde gesagt, statt aufzufüllen.
- KI macht die Analyse billig. Das Prüfen ist jetzt die Kunst: die Rohzeilen öffnen, die Zählung neu laufen lassen und jeden Prozentwert verwerfen, hinter dem keine Datei steht.
Was ist Datenanalyse in der UX-Forschung?
Sie bedeutet, zu lesen, was bereits existiert, bevor Sie etwas Neues machen. Der Eintrag in meinem Leitfaden zum Designprozess steht unter Empathise und nennt einen Grund, sie zuerst zu machen: Sie kostet am wenigsten. Support-Tickets, Verkaufsdaten, Suchprotokolle, App-Bewertungen, alte Forschung. Sie gehen mit einem Wissen darüber, wo Sie hinschauen sollten, und mit den ersten Fragen für Ihre Interviews davon.
Die Nielsen Norman Group nennt die größere Familie Sekundärforschung, auch Desk Research, und sagt, sie sollte in jeder sauberen Forschungspraxis ein Standardschritt am Anfang sein. Ihre Begründung ist praktisch: Hat schon jemand eine Studie gemacht, nutzen Sie sie, und zahlen Sie nicht dafür, neu zu entdecken, was Ihre eigene Organisation vor zwei Jahren gelernt hat.
Es gibt zwei Arten von Daten, die Sie so lesen können.
Ihre eigenen Daten sind das, was Ihr Produkt ohnehin aufzeichnet: Sessions, Funnels, Bestellungen, das Support-Postfach, das Suchfeld, das niemand ansieht. Hier zeigt sich der Absprung: ein Schritt, an dem viele ankommen und wenige in die richtige Richtung weitergehen.
Öffentliche Daten sind das, was die Welt bereits veröffentlicht hat: Finanzierungsnews, Websites von Wettbewerbern, App-Store-Bewertungen, amtliche Statistiken. Das haben wir für Taken apart genutzt. Niemand gab uns Zugang zu irgendetwas. Jede Seite, die wir lasen, konnte jeder Besucher öffnen.
Beide Arten haben dieselbe Stärke und dieselbe Grenze. Sie halten fest, was passiert ist. Sie halten nicht fest, was jemand meinte.
Warum zählen statt fragen?
Weil meine Frage eine „Wie viele“-Frage war, und Menschen beantworten solche Fragen über sich selbst schlecht.
Hätte ich zehn Gründer zu ihren arabischen Websites interviewt, hätte ich zehn Fassungen von „Wir unterstützen Arabisch“ gehört. Das sagen Menschen laut, und es ist keine Lüge. Für einen Gründer zählt eine übersetzte Startseite hinter einem Sprachumschalter als Unterstützung. Die Frage, auf die es ankam, war, wie diese Unterstützung für jemanden aussieht, der auf der Seite landet, für Google und für die Crawler hinter ChatGPT, Claude und Perplexity. Das ist keine Meinung, die jemand hat. Es ist ein Fakt auf einem Server, und man kann ihn lesen gehen.
Das ist die erste Regel für Daten im Design. Nutzen Sie sie für die Fragen, die sie beantworten können: wie viele, wie oft, wo, seit wann. Nutzen Sie Interviews für die Fragen, die sie nicht beantworten können: warum, was wollten Sie erreichen, was haben Sie erwartet.
Wie haben wir gewählt, was wir lesen?
Das ist der Teil, den die meisten Datenanalysen überspringen, und er entscheidet, ob das Ergebnis etwas bedeutet.
Der leichte Weg, diesen Essay zu schreiben, wäre gewesen, zwanzig Startup-Websites zu öffnen, die ich schon kannte, die kaputten zu finden und sie zu zählen. Das ergibt eine auffällige Zahl und beweist nichts. Man findet, wonach man suchte.
Also stand die Reihenfolge fest, bevor eine Seite geöffnet wurde. Wir nutzten eine öffentliche Quelle, die Finanzierungsnews von Wamda, und lasen sie in veröffentlichter Reihenfolge, von neu nach alt: 473 Artikel, vom 23. September 2026 zurück bis zum 30. September 2025. Keine zweite Liste wurde beigemischt, sodass jedes Unternehmen aus demselben geordneten Feed stammte.
Eine Schlagzeile qualifizierte sich nur, wenn sie über ein benanntes Unternehmen berichtete, das Geld einsammelt: eine angekündigte Runde, ein strategisches Investment oder eine Kreditlinie. Fonds, Accelerators, Übernahmen, Exits, Partnerschaften, Launches und wiederholte Erwähnungen desselben Unternehmens schieden aus. Das Land musste eines von neun sein: Saudi-Arabien, VAE, Ägypten, Jordanien, Kuwait, Katar, Bahrain, Oman oder Marokko. Die Branche musste Fintech, E-Commerce, Lieferdienste, Proptech, Gesundheit, Edtech, Mobilität, SaaS oder HR sein. Lizenzierte Banken, staatliche Stellen und Unternehmen, von denen bekannt war, dass sie geschlossen hatten, schieden aus.
184 Unternehmen bestanden. Wir prüften sie der Reihe nach, gute Seiten und schlechte, bis 100 eine arabische Version hatten. Das hundertste war DOO, im Wamda-Artikel vom 30. September 2025. Die ganze Regel steht in der Beschreibung, wie die Stichprobe gezogen wurde, die mit dem Essay veröffentlicht wurde.
Drei Dinge in diesem Absatz leisten die eigentliche Arbeit.
Die Quelle liegt außerhalb von Ihnen. Wir haben die Unternehmen nicht ausgesucht. Wamda tat es, indem es über ihre Finanzierung berichtete. Damit liegt die Auswahl nicht in meiner Hand, und dort sollte sie liegen, wenn ich schon eine Meinung zur Antwort habe.
Die Abbruchregel steht vorher fest. „Bis 100 eine arabische Version hatten“ ist eine Regel, die man prüfen kann. „Bis ich genug hatte“ nicht.
Die Definition ist aufgeschrieben. Arabische Version heißt: Ein Besucher erreicht arabischen Seitentext von der eigenen Website des Unternehmens aus, über einen Sprachumschalter, einen hreflang-Link auf Arabisch, eine arabische Standard-Startseite oder eine Weiterleitung nach Browsersprache. Arabisch, das nur in der mobilen App existiert, zählte nicht. Eine arabische URL, auf die nichts verlinkt, ebenso wenig, und auch kein Umschalter, der die Seite auf Englisch lässt. Das sind Ermessensentscheidungen, und sie stehen in den Notizen, wo man darüber streiten kann.
Die Stichprobe selbst ist eine schlichte Datei, sample.csv: Unternehmen, Land, Branche, Startseite, die arabische URL und der Wamda-Artikel, der das Unternehmen auf die Liste brachte. 100 Zeilen. Jede Zeile lässt sich auf den Artikel zurückführen, der sie rechtfertigt.
Was hat der Scanner tatsächlich geprüft?
Der Scanner ist eine einzige Datei, scan.mjs. Der Kommentar am Anfang listet jede Prüfung auf und nennt die Regel, nach der die ganze Studie läuft: Jede Prüfung ist gemessen, nie geraten.
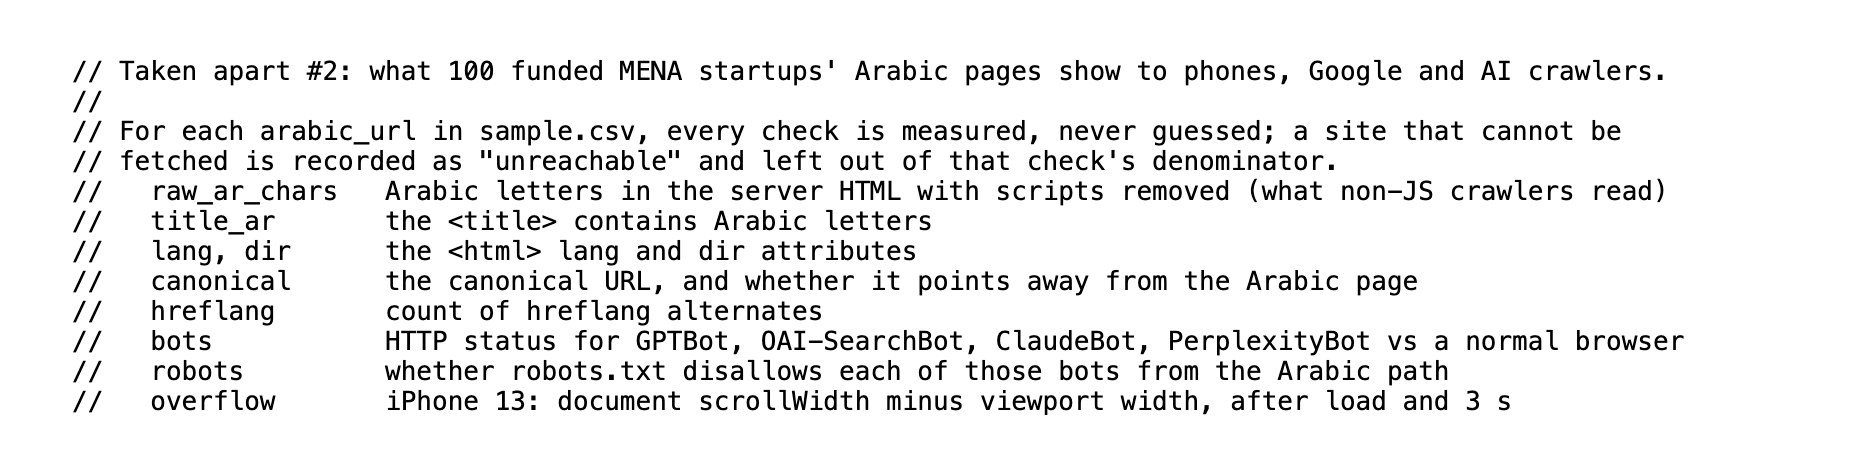
Jede Prüfung steht für eine Person oder eine Maschine, die die Seite liest.
| Prüfung | Was sie liest | Wen sie vertritt |
|---|---|---|
| raw_ar_chars | Arabische Buchstaben im Server-HTML, ohne Skripte | KI-Crawler, die kein JavaScript ausführen |
| title_ar | Ob der Seitentitel Arabisch enthält | Ein arabischer Suchender, der die blaue Zeile in Google liest |
| lang, dir | Sprache und Schreibrichtung der Seite | Browser, Screenreader, Suchmaschinen |
| canonical | Ob die Seite sich selbst oder eine andere Seite als Original nennt | Google, das entscheidet, welche Seite es zeigt |
| hreflang | Wie viele Sprachvarianten die Seite angibt | Google, das die arabische und die englische Seite zuordnet |
| bots | Den HTTP-Status für GPTBot, OAI-SearchBot, ClaudeBot und PerplexityBot im Vergleich zu einem normalen Browser | ChatGPT, Claude und Perplexity |
| robots | Ob robots.txt jeden dieser Bots ausschließt | Die eigenen erklärten Regeln der Website |
| overflow | Wie weit die Seite nach dem Laden auf einem iPhone 13 seitlich verrutscht | Eine Person am Telefon |
Jeder Abruf fragt zuerst nach Arabisch, folgt Weiterleitungen und gibt nach 25 Sekunden auf. Die Telefonprüfung öffnet die Seite im Viewport eines iPhone 13, wartet, bis sie geladen ist, wartet drei weitere Sekunden und misst, wie viel breiter die Seite ist als der Bildschirm.
Die Entscheidung im Design, die mir am wichtigsten ist, klingt am kleinsten. Eine Seite, die nicht abgerufen werden konnte, wird als nicht erreichbar erfasst und bleibt aus dem Nenner dieser Prüfung draußen. Sie zählt nicht als kaputt, und sie zählt nicht als in Ordnung. Sie zählt als unbekannt, und die Unbekannten werden berichtet.
Diese eine Regel ist der Grund, warum der Essay sagen kann „von den 88 arabischen Seiten, die wir vollständig lesen konnten“ statt „von 100“. Fünf Websites lieferten dem Scanner am Tag keine Seite, vier wiesen ihn ab, eine lud nicht, sie bleiben also bei den Seitenprüfungen draußen. Jede hatte bei der Prüfung der Stichprobe auf Arabisch geladen, und so blieben sie drin. Sieben weitere bleiben bei den Textprüfungen draußen: die sechs, die der Essay nennt und deren Adresse sich mit der Sprache nicht ändert, und eine, die ihr Arabisch auf eine Canvas zeichnet, sodass es keinen Text zum Lesen gibt. Die Basen schrumpfen, und jede Zahl nennt, welche Basis sie nutzt: 179 Unternehmen, 88 Seiten, 94 Seiten für die Crawler-Prüfungen und eine andere 94 für die Telefonprüfung.
Warum trägt jede Zahl ihre Basis?
Weil die Basis die Zahl ist. Ein Prozentwert ohne sie ist eine Stimmung.
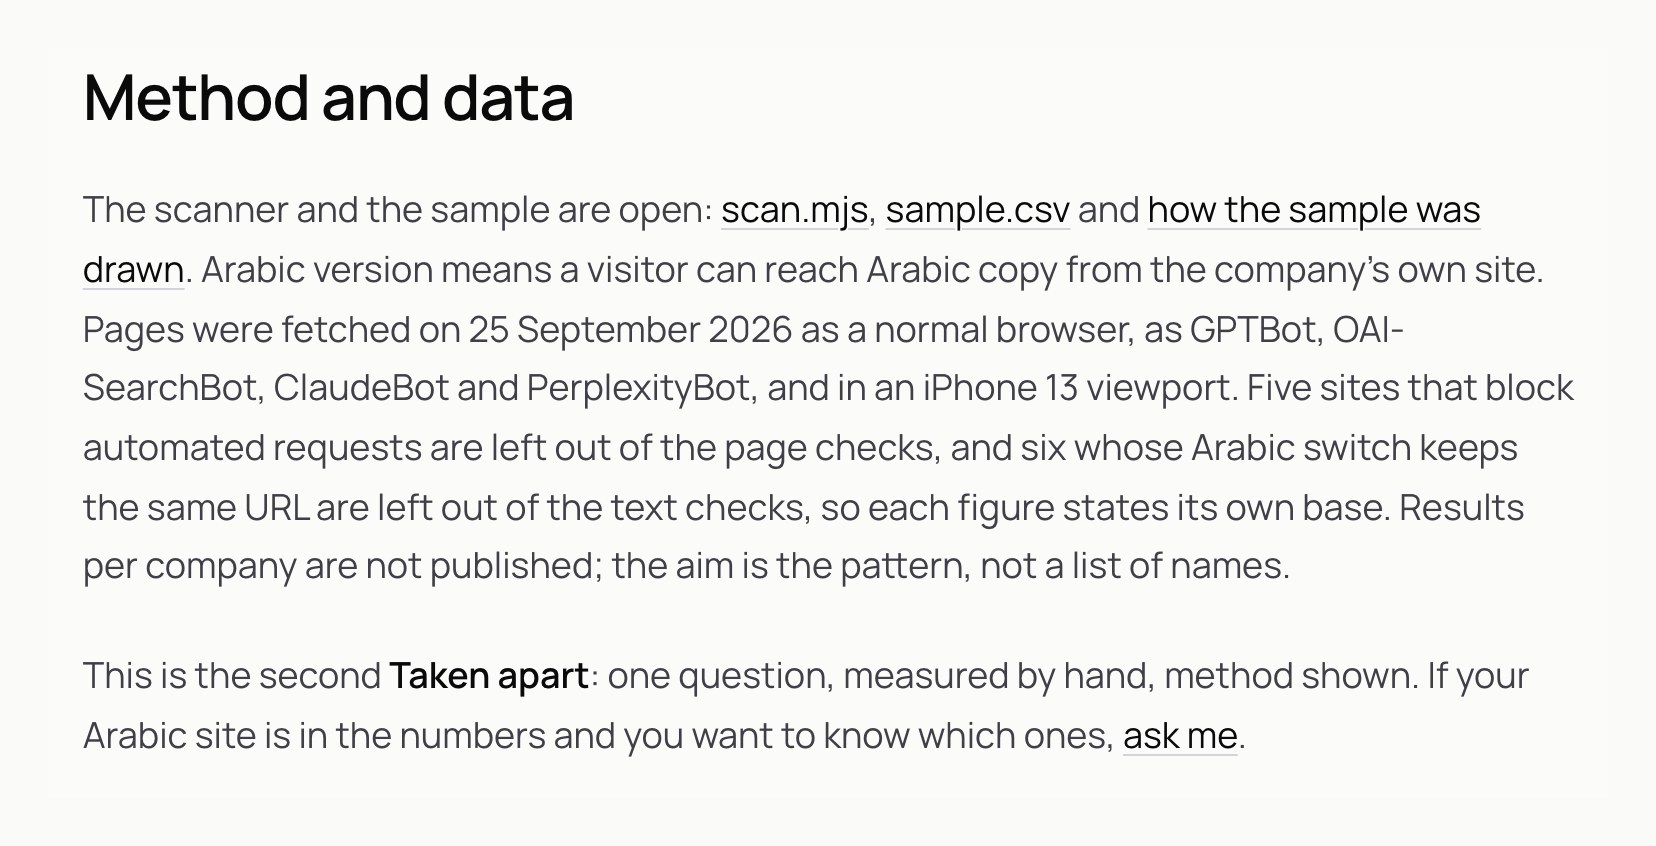
Hier ein echter Fall aus der Studie. Der Essay sagt, 79 von 179 Unternehmen haben keine arabische Version, 44 Prozent. Die am selben Tag veröffentlichten Notizen zur Stichprobe sagen, 79 der 184 hatten eine funktionierende Website ohne arabische Version, 43 Prozent. Dieselben 79 Unternehmen. Zwei verschiedene Prozentwerte.
Beide stimmen. 184 ist jedes Unternehmen, das die Filter passierte. Vier davon hatten keine Website, die wir finden konnten, und eines blieb draußen, weil seine Website uns von unserem Standort aus aussperrte, sodass es so oder so nicht prüfbar war. Nimmt man diese fünf heraus, bleiben die 179, die wir tatsächlich beurteilen konnten. Teilt man durch 184, bleiben fünf Unternehmen in der Basis, die wir nie beurteilt haben. Teilt man durch 179, sagt man nur, was wir gesehen haben.
Dasselbe passiert bei den VAE. Der Essay sagt 53 von 67. Die Notizen zur Stichprobe sagen 53 von 69. Der Unterschied sind zwei VAE-Unternehmen ohne auffindbare Website. Wieder dieselben 53, andere Basis, beides wahr, und nur eines ist eine Aussage über Websites.
Keiner hätte einen der beiden Unterschiede bemerkt, hätten wir „44%“ allein gedruckt. Genau das ist das Problem. Ein nackter Prozentwert versteckt jede Entscheidung dahinter. Die Basis bringt die Entscheidung auf die Seite zurück, wo der Leser sie anfechten kann.
Die Regel zum Mitnehmen, für Forschungsberichte, Dashboards und Pitch-Decks gleichermaßen: erst die Anzahl, dann die Basis, dann der Prozentwert. „79 von 179, 44 Prozent“. Wenn Sie die ersten beiden nicht ausfüllen können, haben Sie den dritten nicht.
Passt die Stichprobe zum Ergebnis?
Eine gute Gewohnheit vor dem Veröffentlichen: die veröffentlichte Datei gegen die veröffentlichte Behauptung prüfen, wie es ein Fremder täte.
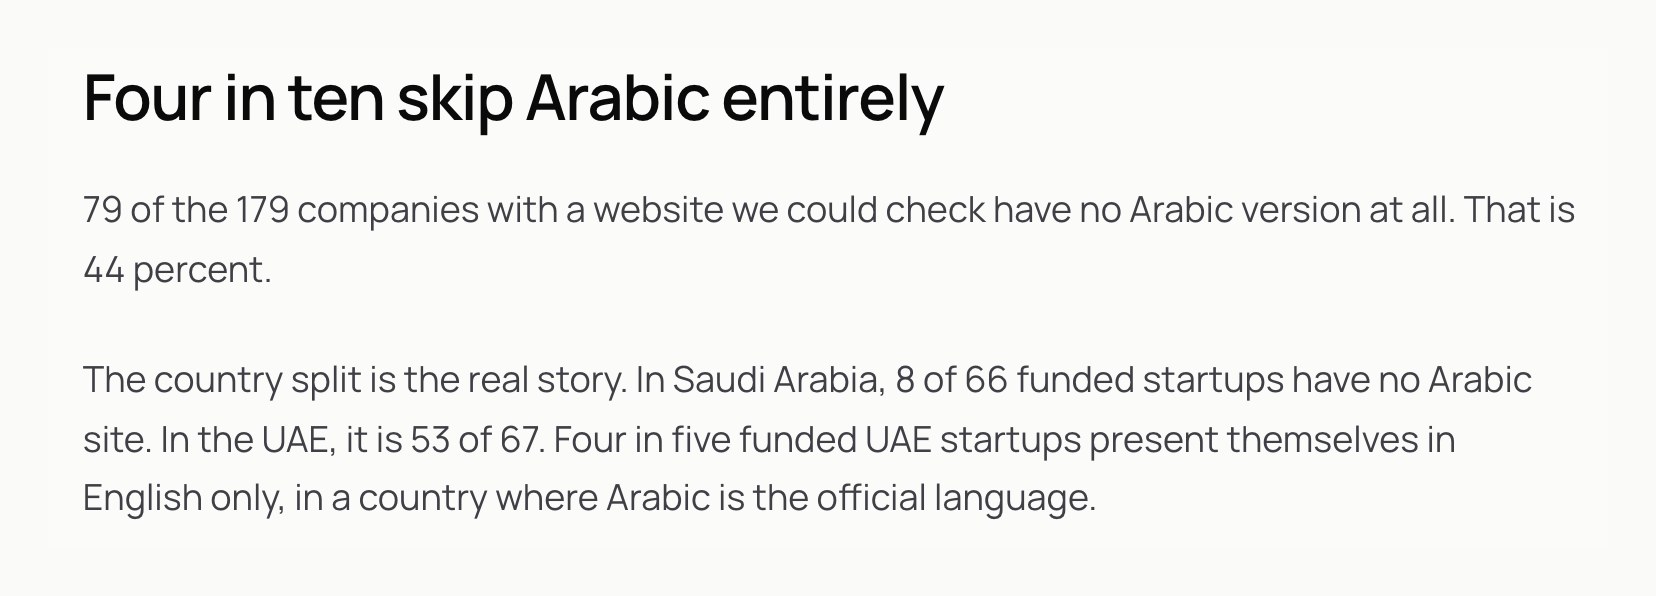
Der Essay sagt, 8 von 66 finanzierten saudischen Startups haben keine arabische Website, also haben 58 eine. Zählen Sie die saudischen Zeilen in sample.csv, und Sie kommen auf 58. Er sagt, 53 von 67 VAE-Startups haben keine arabische Website, also haben 14 eine. Die VAE-Zeilen in der Stichprobe: 14. Datei und Essay stimmen überein, und jeder kann das in einer Minute prüfen.
Die Stichprobe zeigt auch die Form dessen, was gezählt wurde. 28 der 100 Unternehmen sind Fintech, 22 SaaS und 14 E-Commerce. 58 sind saudisch. Jede Aussage über „MENA-Startups“ aus diesen Daten ist in Wahrheit eine Aussage mit Schwerpunkt auf saudischem Fintech und Software. Die Branchenmischung ist, wer in diesem Jahr Geld einsammelte und darüber berichtet wurde. Das saudische Gewicht ist die eigene Regel der Stichprobe bei der Arbeit: Die Liste enthielt ungefähr so viele VAE-Unternehmen wie saudische, 67 und 66, aber nur ein Unternehmen mit arabischer Website gelangt in die Stichprobe. Das ist kein Fehler der Methode. Es ist eine Tatsache darüber, wer in der Datei ist, und man sagt sie laut, statt den Leser annehmen zu lassen, die Stichprobe sehe aus wie die ganze Region.
Eine weitere Kleinigkeit, die die Datei zeigt: In 32 der 100 Zeilen sind die arabische Seite und die Startseite dieselbe Adresse. Manchmal ist das eine arabische Standard-Startseite. Manchmal ist es ein Sprachumschalter, der die Wörter ändert und die URL behält, und das ist der Fall, den die Zählung bei den Textprüfungen draußen lassen musste. Die Datei kann nicht sagen, was was ist. Dafür müssen Sie die Website öffnen.
Was haben die Daten tatsächlich gezeigt?
Von den 88 arabischen Seiten, die wir vollständig lesen konnten, haben 42 mindestens einen Fehler, der das Arabische von der Suche oder von KI-Antworten fernhält. Das sind 48 Prozent.
- 28 haben kein hreflang, 32 Prozent. Google kann nicht erkennen, dass die arabische und die englische Seite derselbe Inhalt in zwei Sprachen sind. Wie hreflang Sprachversionen zuordnet, erklärt Google in der Dokumentation zu lokalisierten Versionen.
- 23 behalten auf der arabischen Seite einen englischen Seitentitel, 26 Prozent.
- 9 haben kein Arabisch auf der Seite, bevor JavaScript läuft, 10 Prozent. Für einen Crawler, der die rohe Seite liest, ist diese arabische Website leer.
- 8 der 94 Seiten in den Crawler-Prüfungen weisen einen KI-Crawler mit einem Fehler glatt ab, 9 Prozent. Nur eine der acht sagt das in robots.txt.
- 3 verweisen Google auf die englische Seite als Original, 3 Prozent.
Das mobile Layout, das, wofür man meistens die Schuld sucht, war überwiegend in Ordnung. 4 von 94 Seiten rutschen auf einem iPhone seitlich weg.
Diese letzte Zeile ist der Grund, zu zählen. Die Zählung legte die Fehler woanders hin, in die Teile, die niemand sieht: ein Title-Tag, ein Link-Element, eine Firewall-Regel. Datenanalyse ist am besten, wenn sie Ihnen beweist, dass Sie sich geirrt haben, wo Sie suchen sollten.
Wo hören die Daten auf?
Sehen Sie sich die acht Websites an, die einen KI-Crawler abweisen. Die Daten sind exakt: Der Crawler fragt nach der Seite, der Server antwortet mit einem Fehler, ein normaler Browser bekommt die Seite. Und nur eine der acht sagt das in robots.txt.
Ob jemand das so gewählt hat, können sie nicht sagen. Der Essay sagt, bei den anderen sieben sei es eine Firewall-Regel, keine Entscheidung, die jemand getroffen hat. Das ist die vernünftigste Lesart der Belege: Eine Entscheidung, die man treffen wollte, steht in robots.txt, und ein Standard, den man nie angesehen hat, sitzt in der Firewall. Aber es bleibt eine Lesart. Der Statuscode ist das Datum. Die Absicht dahinter ist ein Schluss, und der einzige Weg, ihn zur Tatsache zu machen, ist, das Unternehmen zu fragen.
Mit der Zahl für die VAE ist es dasselbe. 53 von 67 finanzierten VAE-Startups haben keine arabische Website. Man kann sich die Gründe vorstellen. Ihre Käufer sind Expats. Ihre Investoren lesen Englisch. Arabisch steht auf der Roadmap. Wir haben nie gefragt. Jeder davon führt zu einer anderen Designentscheidung, und die Daten behandeln alle als dieselbe Zeile.
Der Vergleich von qualitativer und quantitativer Forschung der NN/g sagt es in einer Zeile: Quantitative Daten können Ihnen sagen, dass ein Design womöglich nicht funktioniert, aber sie zeigen nicht, auf welche Probleme Nutzer stießen, und nicht, was Sie ändern sollen. Das ist genau die Grenze des Essays. Er endet mit einem Angebot, „wenn Ihre arabische Website in den Zahlen steht und Sie wissen wollen, welche, fragen Sie mich“, denn der nächste Schritt nach einer Zählung ist immer ein Gespräch.
Wie lesen Sie den Absprung im eigenen Produkt?
Der Taken-apart-Scan nutzt öffentliche Daten. Die meiste Datenanalyse im Design arbeitet mit den Zahlen des eigenen Produkts, und die Form ist dieselbe.
Ein Funnel wie dieser ist die häufigste Form von Absprungdaten. Jeder Schritt listet, wie viele Menschen ihn erreicht haben. Der Schritt, an dem die Zahl am stärksten fällt, ist der, den Sie zuerst ansehen.
So gehe ich vor.
- Schreiben Sie die Frage auf, bevor Sie das Dashboard öffnen. „Wo verlassen die Kunden der Verkäufer den Weg zwischen Warenkorb und Zahlung?“ ist eine Frage. „Schauen wir mal in die Analytics“ ist ein Weg, einen Nachmittag zu verlieren.
- Legen Sie Zeitraum und Quelle fest. Ein Datumsbereich, eine Datenquelle, gewählt, bevor Sie hinsehen. Den Bereich so lange zu ändern, bis das Diagramm interessant aussieht, ist die Dashboard-Fassung davon, zwanzig Websites auszusuchen, die man schon kannte.
- Notieren Sie für jeden Schritt Anzahl und Basis. Nicht „Checkout ist schlecht“. „Von den Menschen, die diesen Monat zur Kasse gelangten, haben so viele bezahlt.“
- Suchen Sie den größten Abfall, nicht jeden Abfall. Jeder Funnel verliert an jedem Schritt. Der, den Sie untersuchen sollten, ist der Schritt, an dem die meisten gehen.
- Lesen Sie die Rohzeilen dahinter. Öffnen Sie echte Sessions, echte Bestellungen, echte Tickets aus diesem Schritt. Durchschnitte verbergen die Person, die es dreimal versucht hat.
- Halten Sie an und schreiben Sie die Fragen für Interviews. Das Ergebnis der Datenanalyse ist keine Lösung. Es ist eine kurze Liste von Menschen, mit denen Sie sprechen sollten, und was Sie sie fragen.
Schritt sechs überspringen die Leute. Der Funnel sagt, dass viele an der Kasse gehen. Er sagt nicht, ob die Liefergebühr sie überrascht hat, die Zahlungsart fehlte, die Seite in der falschen Sprache war oder sie nur Preise verglichen. Jedes davon ist ein anderer Screen. Wählen Sie einen, ohne zu fragen, gestalten Sie für Ihre eigene Vermutung, mit einem Diagramm, das sie wie Forschung aussehen lässt.
Was tun Sie mit dem Warum?
Holen Sie es bei den Menschen.
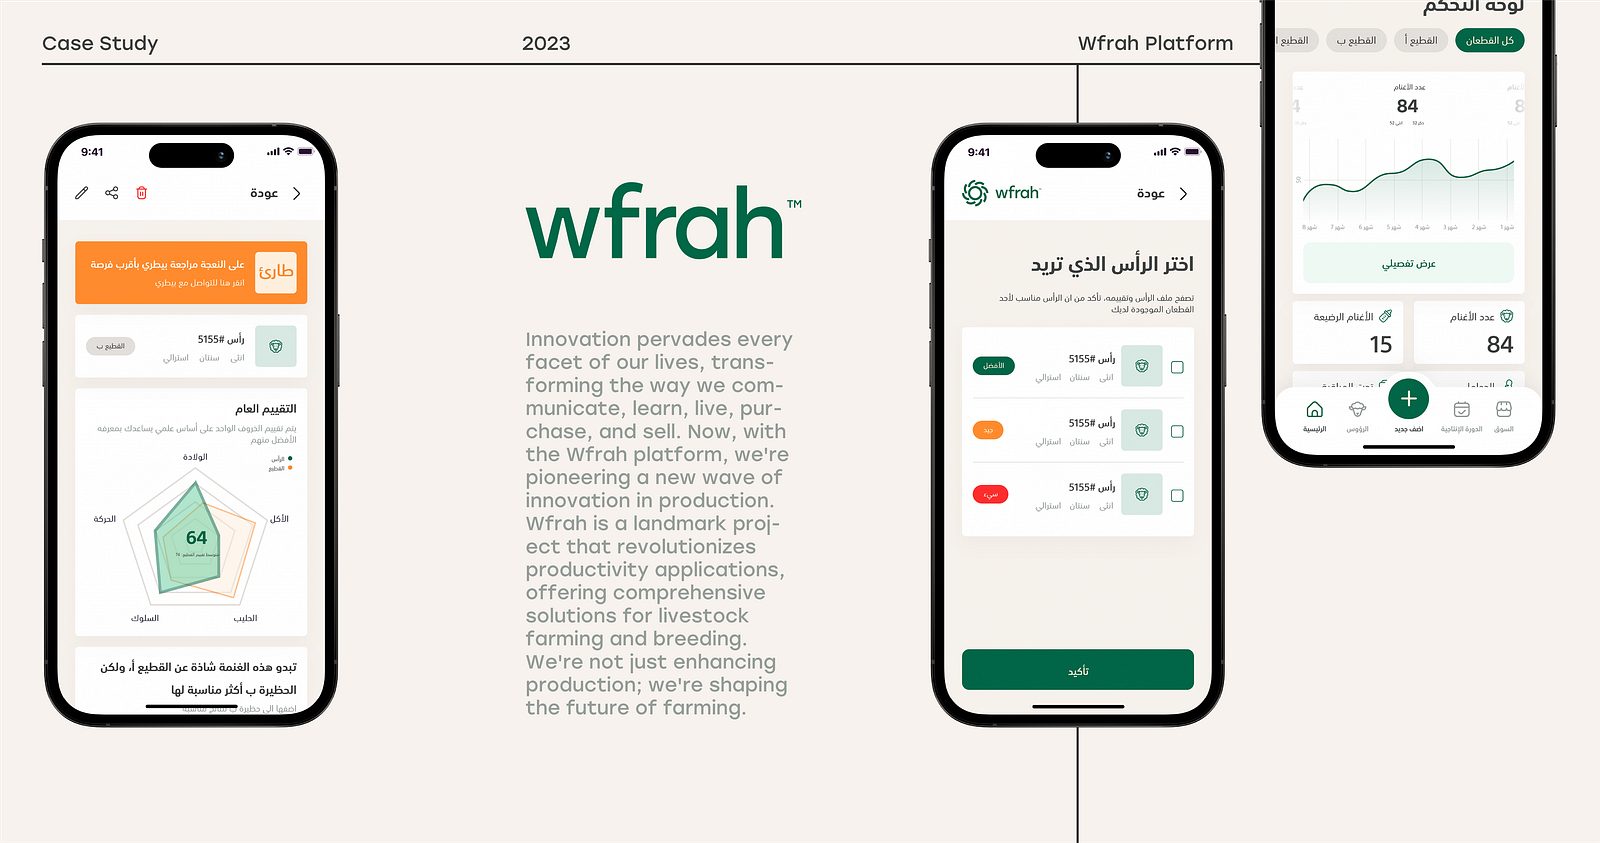
Bei Wfrah, der App, die wir für Schaf- und Ziegenzüchter am Golf gestaltet haben, gaben Züchter laut dieselbe Antwort: Das Futter ist teuer, und die Käufer zahlen zu wenig. Zählte man nur, was Menschen sagen, wäre das Ihr Befund. Die Interviews zeigten, was darunter lag. Vielen Züchtern fiel es schwer, den täglichen Bedarf der Herde aus den Formeln zu berechnen, und die Schuld beim Markt zu suchen machte es leicht, Ernährung und Management zu übersehen. Deshalb enthält die App einen Nährstoffrechner, der die Rechnung für sie übernimmt.
Die Arbeitsreihenfolge ist einfach. Datenanalyse findet das Wo und bemisst es. Interviews finden das Warum. Ein aus den Daten gebautes Nutzerinterview-Skript fragt nach dem letzten Mal, als die Person genau an diesen Schritt kam. Eine Affinity Map sortiert, was sie gesagt haben, mit einem Teilnehmer-Kürzel an jeder Notiz, damit Sie jedes Thema auf eine Person zurückführen können. Dann sagt eine Problemformulierung, was Sie beheben und für wen, mit der Zahl aus Ihren Daten als Beleg für die Größe.
Wie nutzen Sie KI für Datenanalyse, ohne sich selbst zu täuschen?
KI hat diese Methode erheblich billiger gemacht. Ein Modell liest tausend App-Bewertungen in einer Minute, sortiert Support-Tickets in Themen, schreibt den Scraper und entwirft den Bericht. Die Werkzeuge entwickeln sich schnell. Ein Show HN für Graphene vom Oktober 2026, ein Toolkit für Datenanalyse mit Coding-Agenten, stellte die offene Frage klar. Die Entwickler fragten, ob ein Coding-Agent heute den Großteil der Arbeit eines BI-Teams erledigen kann, und antworteten: fast. Sie bräuchten eine Kontextschicht, „um die Korrektheit der Abfragen sicherzustellen“.
Korrektheit ist das ganze Spiel. Ein Modell, das die Abfrage leicht falsch hat, liefert trotzdem ein selbstsicheres Diagramm. Ein Modell, das Forschung zusammenfassen soll, schreibt bereitwillig „die meisten Nutzer“ oder einen runden Prozentwert, der aus dem Nichts kam. Die Ausgabe sieht fertig aus, und fertig ist nicht dasselbe wie wahr.
Was Taken apart ehrlich hielt, war kein klügeres Modell. Es war eine Reihe von Regeln, die die Arbeit überprüfbar machen, und sie gelten für jede Analyse, die eine KI berührt.
Lassen Sie sie Code schreiben, nicht Schlussfolgerungen. Der Scanner ist eine Datei, die Seiten abruft und festhält, was sie sah. Er entscheidet nichts. Bitten Sie das Modell um das Skript, das zählt, und führen Sie es selbst aus. Ein Skript kann man neu lesen und neu laufen lassen. Einen Absatz nicht.
Lassen Sie sie Unbekanntes festhalten. „Gemessen, nie geraten“ steht aus gutem Grund in den ersten Zeilen des Scanners. Füllt ein Modell einen fehlenden Wert mit einem wahrscheinlichen, ist Ihr Ergebnis teils Daten und teils Fiktion, und Sie können nicht sagen, welcher Teil was ist.
Verlangen Sie für jede Zahl die Basis. Jeder Prozentwert in einer KI-Zusammenfassung bekommt zwei Fragen: von wie vielen, und welche Datei. Kann sie nicht beides beantworten, streichen Sie ihn. Keine Ausnahme für Zahlen, die richtig klingen.
Öffnen Sie die Rohzeilen selbst. Bevor Sie einem Thema vertrauen, lesen Sie fünf echte Bewertungen darin. Bevor Sie einer Zählung vertrauen, öffnen Sie drei der gezählten Websites. Die Stichprobe von Taken apart besteht diesen Test: Die saudischen und die VAE-Zahlen in der CSV stimmen mit dem Essay überein.
Halten Sie Reihenfolge und Abbruchregel außerhalb des Modells. Das Modell sollte nicht entscheiden, welche Datensätze gelesen werden oder wann Schluss ist. Dort schleicht sich ein bequemes Ergebnis am leichtesten ein, und es ist eine Entscheidung, die Ihnen gehört.
Veröffentlichen Sie die Methode, wenn Sie die Zahl veröffentlichen. Der Scanner, die Stichprobe und die Notizen zur Stichprobe liegen neben dem Essay. Das ist die stärkste Kontrolle, die es gibt. Habe ich etwas falsch gemacht, kann es jeder finden.
Die andere Hälfte habe ich in Kann KI Nutzerforschung ersetzen beschrieben: Ein Modell ist gut im Entwerfen, Sortieren und Auflisten und schlecht darin, Ihr Nutzer zu sein. Datenanalyse ist zugleich der Ort, an dem es am nützlichsten und am gefährlichsten ist, weil die Ausgabe aus Zahlen besteht und Menschen Zahlen vertrauen, ohne sie zu lesen.
Wann sollten Sie nicht mit Daten beginnen?
Wenn es noch nichts zu lesen gibt oder wenn Ihre Daten das Falsche zählen.
Eine neue Idee ohne Produkt hat keine Sessions zum Analysieren. Öffentliche Daten können trotzdem helfen: Websites von Wettbewerbern, Bewertungen des nächsten Produkts, die Sprache der Leute in Foren. Aber die Hauptforschung sind Interviews, und Sie sollten nicht auf Zahlen warten, die es nicht gibt.
Sechs Umfrageantworten sind ein Hinweis, kein Befund. Rechnen Sie keine Durchschnitte auf die Dezimalstelle und präsentieren Sie sie nicht als Ergebnis. Sagen Sie, was sie nahelegen, und gehen Sie fragen.
Eine Kennzahl kann das falsche Ergebnis verfolgen. Klicks, Verweildauer und Sessions können alle steigen, wenn eine Seite verwirrt. Belohnen Ihre Daten das falsche Verhalten, lässt mehr Analyse das Problem nur präziser aussehen. Entscheiden Sie zuerst, was der Nutzer erledigen will, und wählen Sie dann die Zahl, die das verfolgt.
Die Bevölkerung schreibt womöglich in einer Sprache, die Ihre Tools schlecht lesen. Arabische Bewertungen mit Dialekt, gemischten Schriften und transliteriertem Englisch sind für Tools schwer zu sortieren, und die Fehler sehen Sie nur, wenn Sie die Bewertungen selbst lesen. Das ist ein Grund, warum Taken apart Dinge zählte, die eine Maschine exakt liest, arabische Buchstaben und Statuscodes, und alles mied, wofür ein Modell Bedeutung raten muss.
Wie sieht das beim nächsten Mal aus?
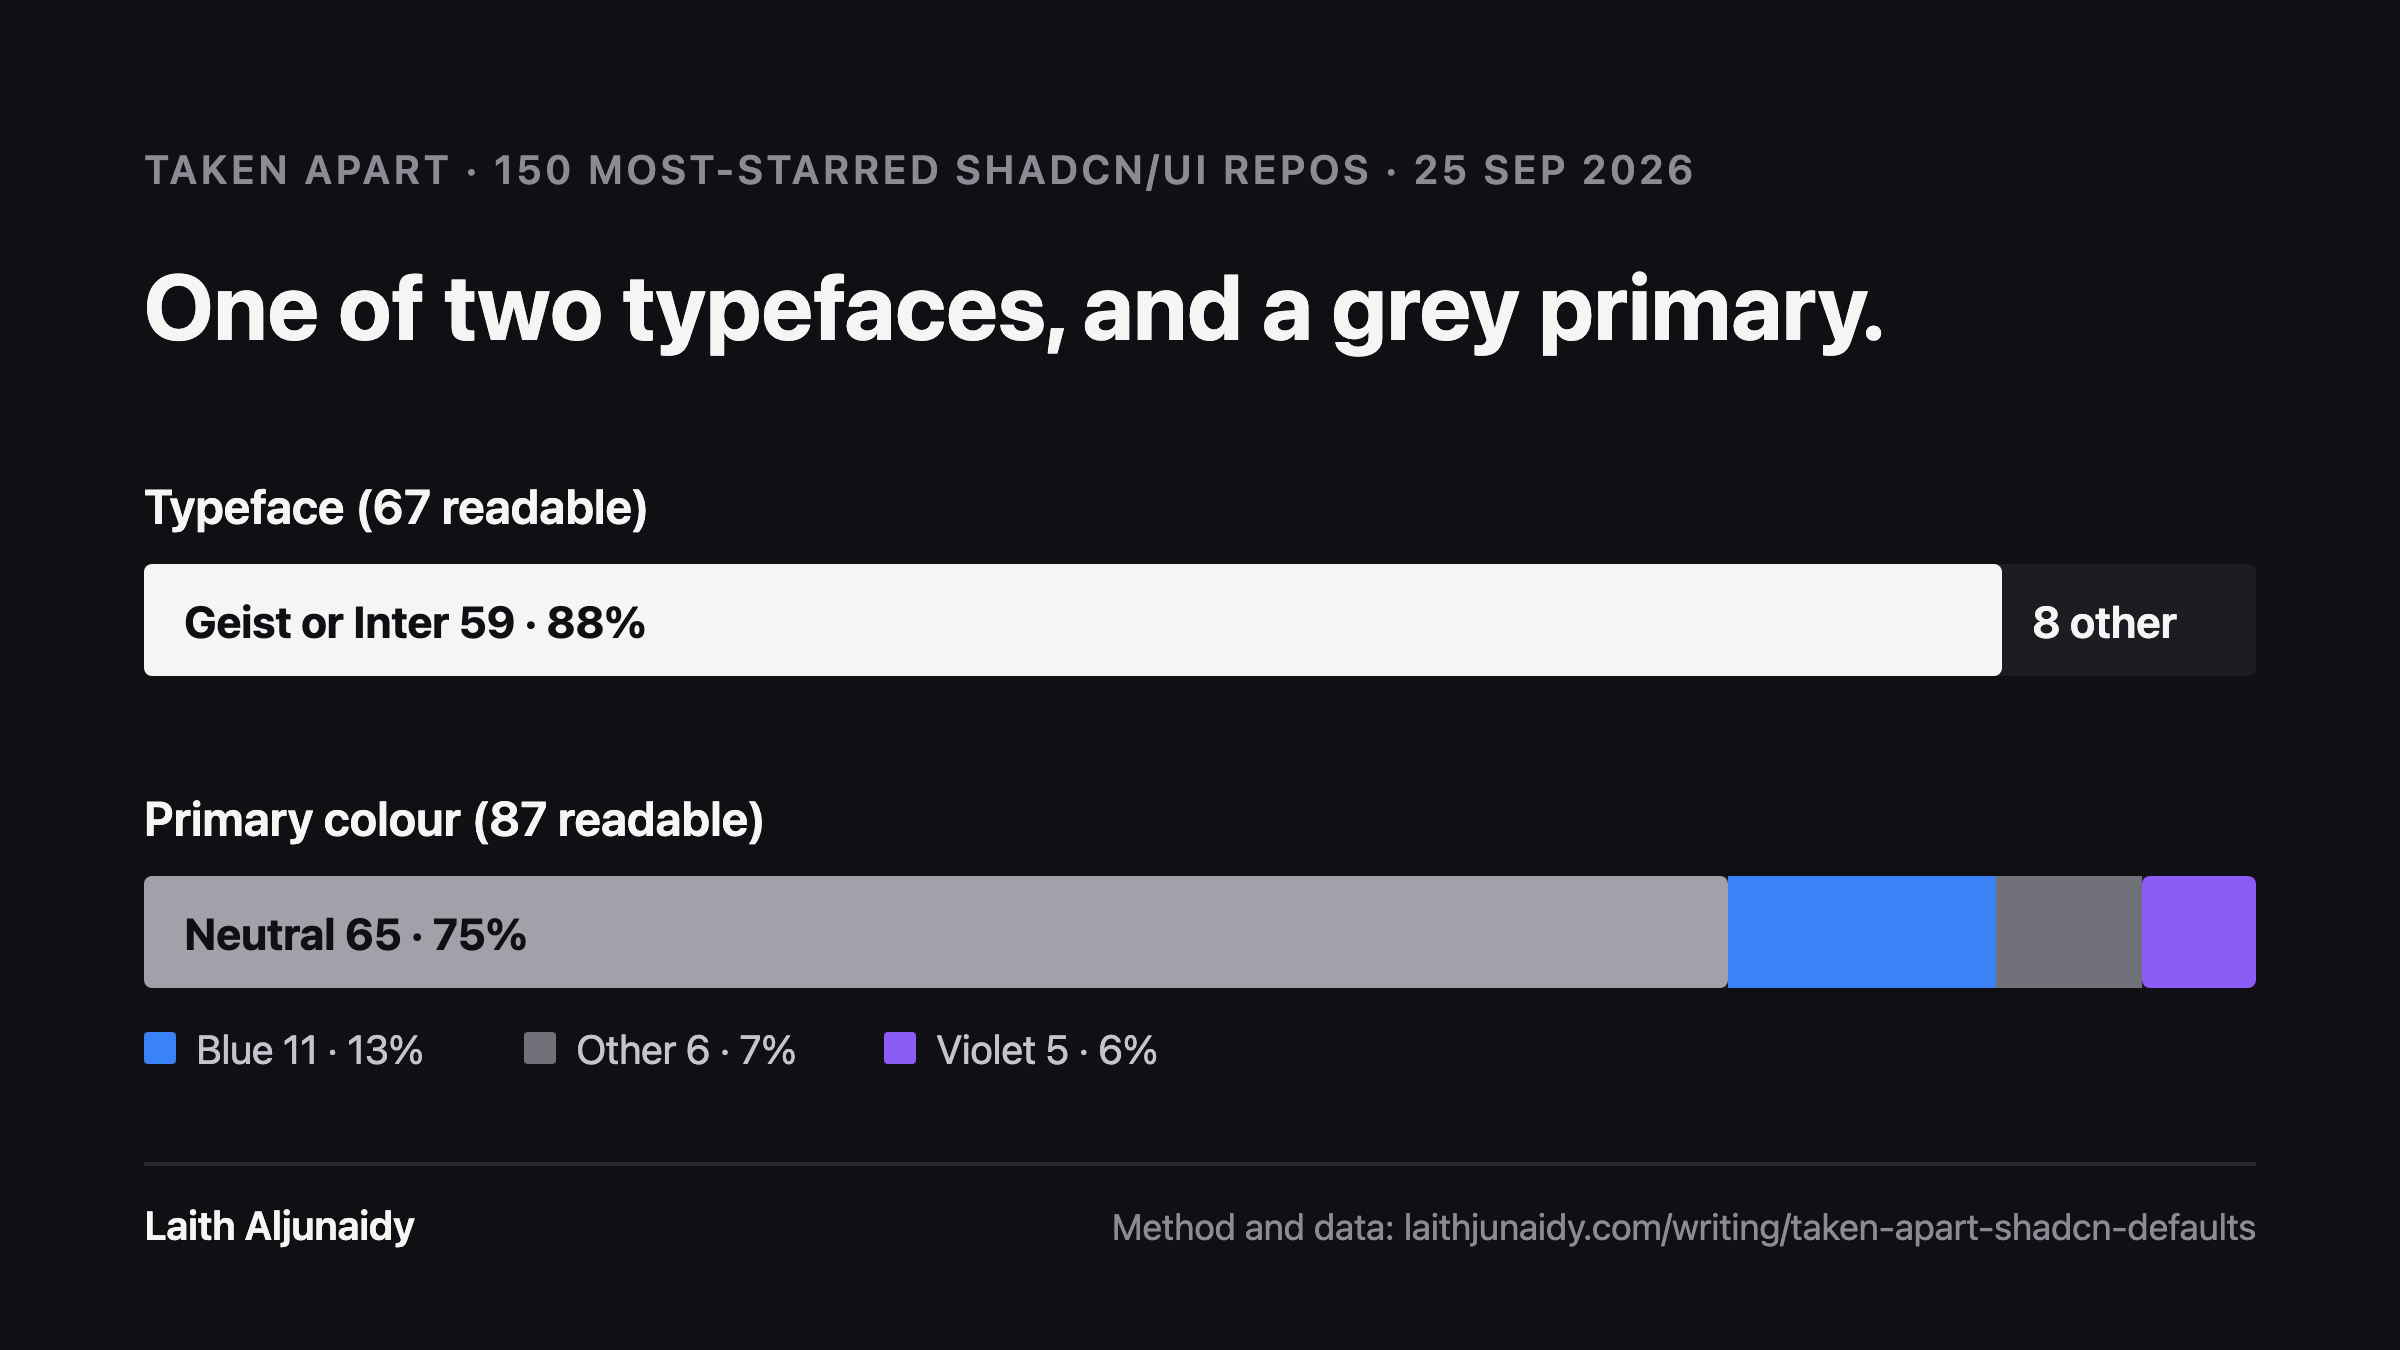
Dieselbe Methode funktioniert in jeder Größe. Taken apart, Nummer eins lief auf GitHub statt auf Websites: die 150 meistbesternten shadcn/ui-Repositories, mit Schrift und Primärfarbe aus dem Code gelesen. Ein Repo, bei dem das Signal nicht lesbar war, zählte als nicht lesbar, nie als geraten, sodass 67 mit lesbarer Schrift übrig blieben. 59 dieser 67 nutzen Geist oder Inter. Dieselben Regeln, andere Quelle.
Wenn Sie Ihre eigene Fassung durchführen wollen, geht es in dieser Reihenfolge:
- Eine Frage, die Sie mit einer Zählung beantworten können.
- Eine Quelle, in fester Reihenfolge gelesen, mit schriftlichen Regeln, was sich qualifiziert.
- Eine vorher festgelegte Abbruchregel.
- Definitionen, geschrieben vor dem ersten Datensatz.
- Ein Scanner oder eine Abfrage, die misst und Unbekanntes festhält.
- Jedes Ergebnis als Anzahl, Basis, Prozentwert.
- Ein Abgleich der veröffentlichten Datei mit der veröffentlichten Behauptung.
- Methode und Stichprobe neben der Zahl veröffentlicht.
- Eine Liste der Menschen, die Sie jetzt nach dem Warum fragen müssen.
Der letzte Schritt macht aus Analyse Design. Die Zählung sagt Ihnen, dass 53 von 67 finanzierten VAE-Startups nur Englisch haben. Dafür brauchte es weder Zugang noch jemandes Erlaubnis. Das Warum herauszufinden wird Gespräche brauchen, und der Grund wird entscheiden, was jemand bauen sollte.
Häufige Fragen
Was ist Datenanalyse in der UX?
Zu lesen, was bereits existiert, bevor Sie etwas Neues erforschen oder gestalten: Analytics, Funnels, Verkäufe, Support-Tickets, Suchprotokolle, App-Bewertungen und öffentliche Daten. Sie zeigt, wo Menschen abspringen und wie viele betroffen sind. Es ist die billigste Forschungsmethode, also kommt sie zuerst, und sie endet mit Fragen für Interviews, nicht mit einer Lösung.
Was ist der Unterschied zwischen Datenanalyse und Sekundärforschung?
Sie überschneiden sich. Sekundärforschung, auch Desk Research, sammelt, was andere bereits herausgefunden haben: Berichte, Studien, alte Forschung. Datenanalyse liest Rohdaten selbst, die Zahlen des eigenen Produkts oder öffentliche Daten, und zählt etwas. Taken apart war Datenanalyse auf öffentlichen Daten: ein Finanzierungs-Feed, der Reihe nach gelesen, und die arabischen Seiten von 100 Unternehmen, von einem Scanner geprüft.
Können Daten sagen, warum Nutzer abspringen?
Nein. Daten zeigen, wo Menschen gehen und wie viele. Sie zeigen nicht, was sie erreichen wollten, was sie verwirrte oder was sie erwarteten. Die NN/g sagt dasselbe: Quantitative Daten können sagen, dass etwas nicht funktioniert, aber nicht, auf welche Probleme Nutzer stießen oder was zu ändern ist. Nutzen Sie die Daten, um zu wählen, wen Sie interviewen und was Sie fragen.
Wie werten Sie Kundenfeedback mit KI aus?
Geben Sie dem Modell das Roh-Feedback, bitten Sie um Themen mit jedem Eintrag samt Quelle, und bitten Sie um Zählungen mit ihrer Basis. Lesen Sie dann selbst fünf echte Einträge in jedem Thema, streichen Sie jeden Prozentwert ohne Anzahl und ohne Datei dahinter, und behandeln Sie das Ergebnis als Fragen für Interviews. KI sortiert schnell. Eine Quelle der Wahrheit ist sie nicht.
Wie groß muss eine Stichprobe sein?
Groß genug für die Frage, und festgelegt, bevor Sie hinsehen. Taken apart setzte die Regel vorher: jedes passende Unternehmen der Reihe nach prüfen, bis 100 eine arabische Version hatten, was 184 Unternehmen brauchte. Eine winzige Stichprobe wie sechs Umfrageantworten kann trotzdem nützlich sein, als Grund, mit Menschen zu sprechen, nie als Befund für sich.
Warum Scanner und Stichprobe veröffentlichen?
Weil eine Zahl, die niemand prüfen kann, eine Behauptung ist und kein Befund. Wer scan.mjs, sample.csv und die Beschreibung, wie die Stichprobe gezogen wurde veröffentlicht, ermöglicht jedem, die Studie neu laufen zu lassen, einen Fehler zu finden oder sie zu erweitern. Die Ergebnisse pro Unternehmen blieben privat. Das Muster war der Punkt, nicht eine Liste von Namen.
Quellen
- Sekundärforschung nngroup.com
- Finanzierungsnews wamda.com
- lokalisierten Versionen developers.google.com
- Vergleich von qualitativer und quantitativer Forschung der NN/g nngroup.com
- Show HN für Graphene news.ycombinator.com