Veri, insanların nerede ayrıldığını söyler. Nedenini asla söylemez.
Bir yıllık yatırım haberini ve 100 Arapça siteyi nasıl okuduk, sayılar neyi kanıtladı, neyi kanıtlayamadı ve veri analizi nasıl yürütülür.
Bu sayfada
- Temel çıkarımlar
- UX araştırmasında veri analizi nedir?
- Neden sormak yerine sayalım?
- Neyi okuyacağımızı nasıl seçtik?
- Tarayıcı gerçekte neyi kontrol etti?
- Neden her sayı tabanını taşır?
- Örneklem sonuçla uyuşuyor mu?
- Veri gerçekte ne buldu?
- Veri nerede durur?
- Kendi ürününüzdeki terki nasıl okursunuz?
- Nedeni ne yapmalı?
- Kendinizi kandırmadan veri analizinde yapay zekayı nasıl kullanırsınız?
- Veriyle ne zaman başlamamalısınız?
- Bir sonraki sefer bu neye benzer?
- Sıkça sorulan sorular
- Kaynaklar
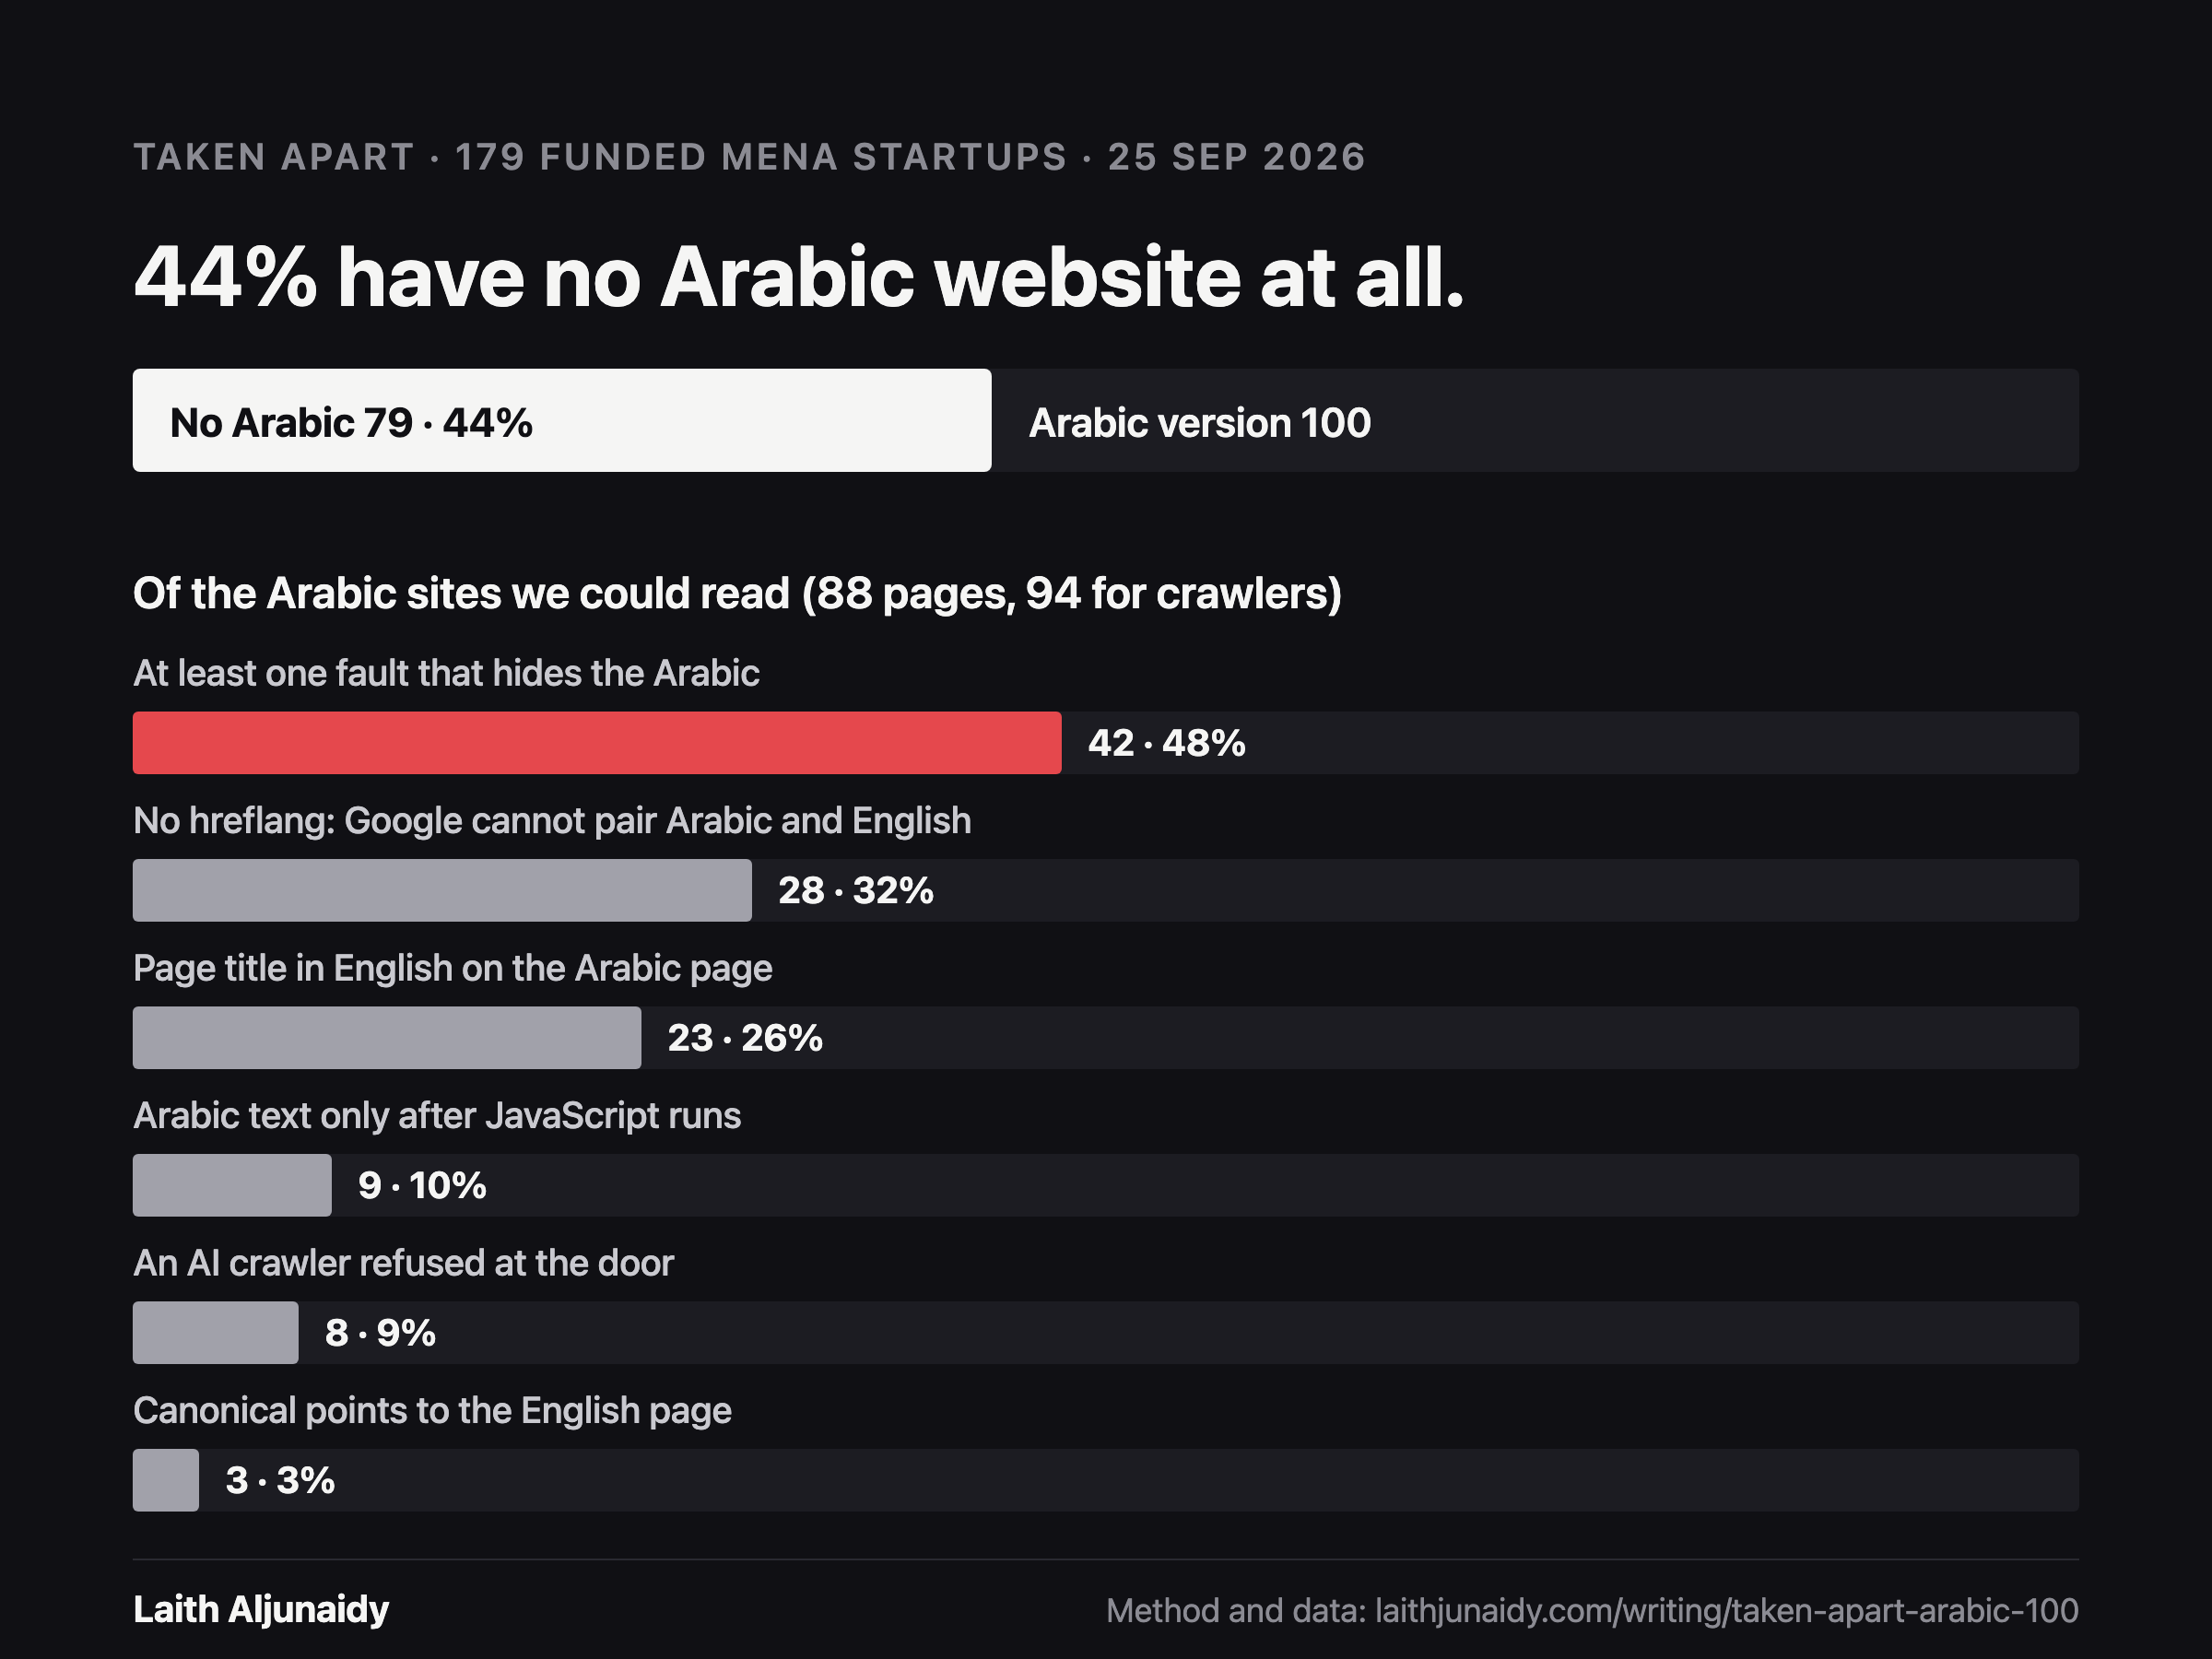
25 Eylül 2026’da Parçalarına ayırdık, ikinci sayı’yı yayımladım. Bölgede, kontrol edebildiğimiz bir web sitesi olan yatırım almış 179 girişimin 79’unun hiç Arapça sürümü yoktu. Bu yüzde 44.
Bölgedeki her kurucu Arapça için aynı şeyi söylüyor: tabii ki destekliyoruz. Bunun sayfada ne anlama geldiğini bilmek istedim, bu yüzden sormayı bırakıp saydım. Tek bir herkese açık liste, sırayla okundu, her şirket kontrol edildi, seçme yok. Sonucu yayımlayan commit’te Claude ortak yazar olarak yer alıyor. Tarayıcı, örneklem ve örneklemin nasıl oluşturulduğuna dair notlar, herkesin yeniden çalıştırabilmesi için yazının yanında açık olarak yayımlandı.
Bu sayı artık tasarım süreci rehberimdeki Veri analizi bölümünün örneği. İkinci kez okuyun, sınır sonucun içinde duruyor. Veri, yatırım almış 67 BAE girişiminden 53’ünün kendini yalnızca İngilizce tanıttığını söylüyor. Nedeni hakkında tek kelime etmiyor. Kurucuların bilerek mi seçtiği, unuttuğu mu, karşılayamadığı mı, alıcılarının Arapça okuduğunu hiç düşünmediği mi? Verebileceğim her neden, bulgu kılığına girmiş bir tahmin olurdu.
O boşluk yöntemin tamamı. Veri analizi insanların nerede ayrıldığını söyler. Nedenini asla söylemez. Bu, taramanın gerçekte nasıl kurulup okunduğu ve tasarımda veri kullanmak hakkında öğrettikleri.
Temel çıkarımlar
- Veri analizi, yeni bir şey yapmadan önce var olanı okumaktır: analitik, satış, destek talepleri, arama kayıtları, uygulama yorumları, kamuya açık veriler, eski araştırmalar. Var olan en ucuz araştırma, bu yüzden önce gelir.
- Nerede ve kaç tane sorusunu yanıtlar. Neden sorusunu yanıtlayamaz. Neden, görüşmelerden ve insanları izlemekten gelir; veri size kime ve neyi soracağınızı söyler.
- Bakmadan önce kaynağa ve sıraya karar verin. Wamda’nın yatırım haberlerini en yeniden en eskiye okuduk ve ölçütleri karşılayan her şirketi sırayla kontrol ettik. Hiçbir şirket sorunlu olduğu için seçilmedi.
- Her sayı tabanını taşır. Aynı 79 şirket, 179’un yüzde 44’ü ve 184’ün yüzde 43’üdür. İkisi de doğru. Yalnızca biri paydası olmadan dürüsttür.
- Ölçülür, asla tahmin edilmez. Okunamayan bir site o kontrolün dışında bırakıldı ve bu söylendi, doldurulmadı.
- Yapay zeka analizi ucuzlatır. Artık beceri onu kontrol etmek: ham satırları açın, sayımı yeniden yapın ve arkasında dosya olmayan her yüzdeyi atın.
UX araştırmasında veri analizi nedir?
Yeni bir şey yapmadan önce var olanı okumaktır. Tasarım süreci rehberimdeki madde Empati kurma altında yer alır ve önce yapmak için tek bir neden verir: en az maliyetli olması. Destek talepleri, satış verileri, arama kayıtları, uygulama yorumları, eski araştırmalar. Nereye bakacağınızı ve görüşmeleriniz için ilk soruları bularak ayrılırsınız.
Nielsen Norman Group daha geniş aileye ikincil araştırma diyor, masabaşı araştırma olarak da bilinir, ve bunun her titiz araştırma pratiğinde standart bir ilk adım olması gerektiğini söylüyor. Çerçeveleri pratik: biri zaten bir çalışma yaptıysa onu kullanın ve kendi kuruluşunuzun iki yıl önce öğrendiğini yeniden keşfetmek için ödeme yapmayın.
Bu şekilde okuyabileceğiniz iki tür veri var.
Kendi verileriniz, ürününüzün zaten kaydettiği şeylerdir: oturumlar, hunileri, siparişler, destek gelen kutusu, kimsenin bakmadığı arama kutusu. Terk burada görünür: çok sayıda insanın vardığı ve az sayıda insanın doğru yönde çıktığı bir adım.
Kamuya açık veriler, dünyanın zaten yayımladığı şeylerdir: yatırım haberleri, rakiplerin web siteleri, uygulama mağazası yorumları, resmî istatistikler. Parçalarına ayırma çalışmasında kullandığımız bu. Kimse bize hiçbir şeye erişim vermedi. Okuduğumuz her sayfayı herhangi bir ziyaretçi açabilirdi.
İki türün de gücü ve sınırı aynı. Ne olduğunu kaydederler. Kimsenin ne demek istediğini kaydetmezler.
Neden sormak yerine sayalım?
Çünkü elimdeki soru bir “kaç tane” sorusuydu ve insanlar kendileri hakkındaki bu soruları kötü yanıtlar.
Kurucularla Arapça siteleri hakkında on görüşme yapsaydım “Arapçayı destekliyoruz”un on sürümünü duyardım. İnsanların yüksek sesle söylediği bu ve yalan değil. Bir kurucu için bir dil anahtarının arkasındaki çevrilmiş ana sayfa destek sayılır. Önemli olan soru, bu desteğin sayfaya inen biri için, Google için ve ChatGPT, Claude ve Perplexity’nin arkasındaki tarayıcılar için neye benzediğiydi. Bu, kimsenin sahip olduğu bir görüş değil. Bir sunucuda duran bir olgu ve gidip okuyabilirsiniz.
Tasarımda veri kullanmanın ilk kuralı bu. Onu yanıtlayabildiği sorular için kullanın: kaç tane, ne sıklıkta, nerede, ne zamandan beri. Yanıtlayamadıkları için görüşmeleri kullanın: neden, ne yapmaya çalışıyordunuz, ne olmasını beklediniz.
Neyi okuyacağımızı nasıl seçtik?
Çoğu veri analizinin atladığı kısım bu ve sonucun bir anlam taşıyıp taşımadığını belirleyen de o.
Bu yazıyı yazmanın kolay yolu, zaten tanıdığım yirmi girişim sitesini açmak, bozuk olanları bulmak ve saymak olurdu. Bu çarpıcı bir sayı üretir ve hiçbir şeyi kanıtlamaz. Aramaya çıktığınızı bulursunuz.
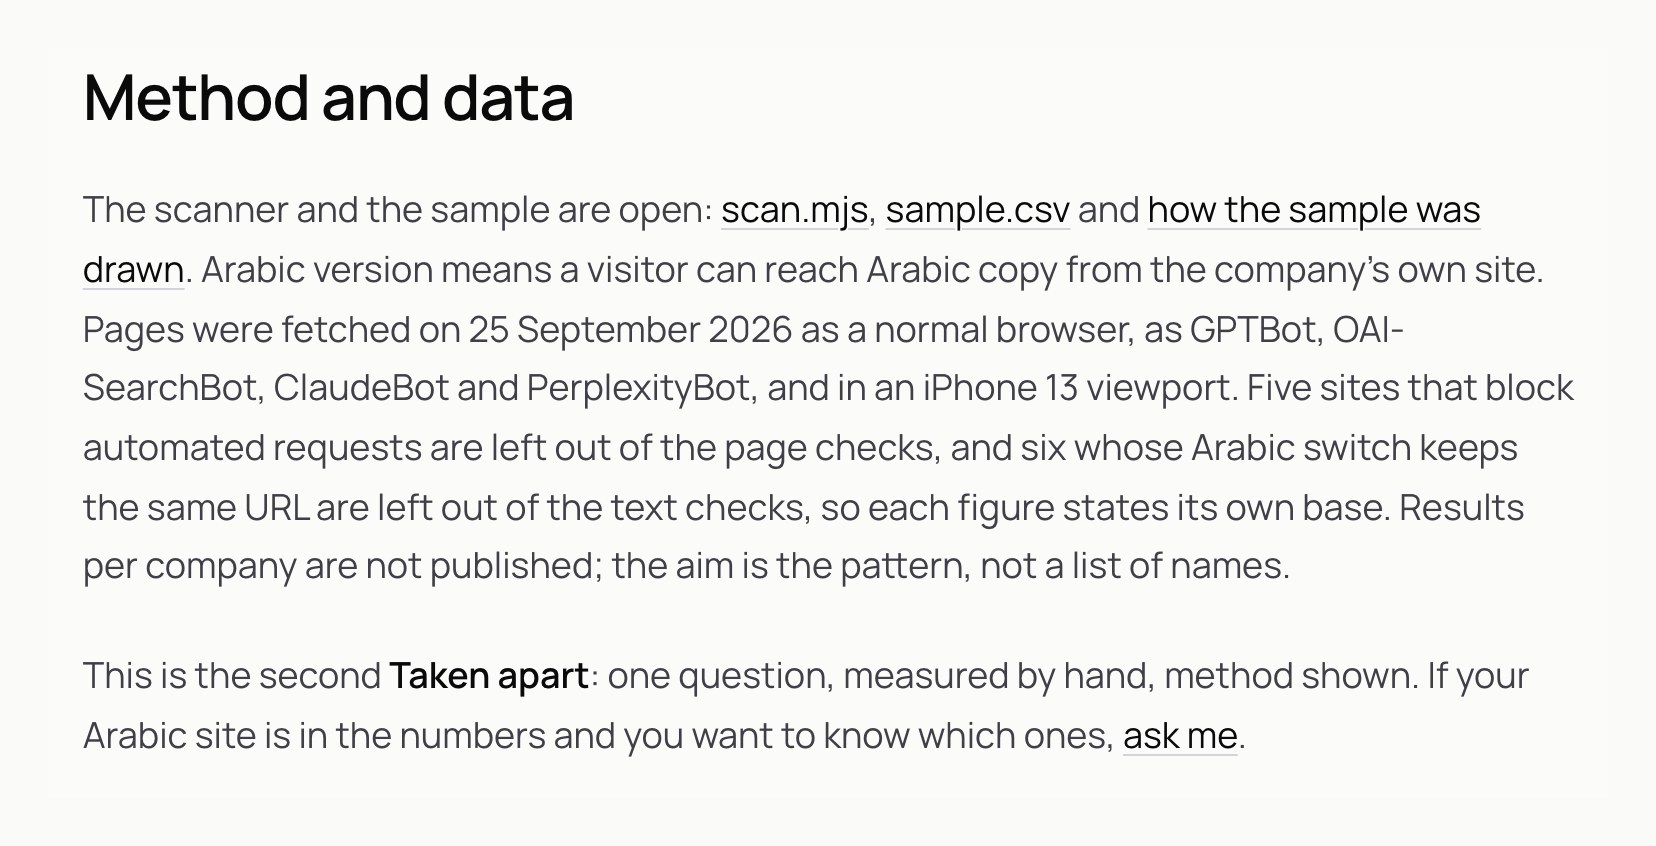
Bu yüzden sıra, herhangi bir site açılmadan önce sabitlendi. Tek bir kamuya açık kaynak kullandık, Wamda’nın yatırım haberleri, ve yayım sırasıyla, en yeniden en eskiye okuduk: 23 Eylül 2026’dan 30 Eylül 2025’e uzanan 473 makale. İkinci bir liste karıştırılmadı; yani her şirket aynı sıralı akıştan geldi.
Bir başlık yalnızca adı belli bir şirketin para topladığını bildiriyorsa nitelikliydi: duyurulmuş bir tur, stratejik yatırım ya da kredi imkânı. Fonlar, hızlandırıcılar, satın almalar, çıkışlar, ortaklıklar, lansmanlar ve aynı şirketin tekrar anılması dışarıdaydı. Ülke dokuzdan biri olmalıydı: Suudi Arabistan, BAE, Mısır, Ürdün, Kuveyt, Katar, Bahreyn, Umman ya da Fas. Sektör şunlardan biri olmalıydı: fintek, e-ticaret, teslimat, proptech, sağlık, edtech, mobilite, SaaS ya da İK. Lisanslı bankalar, devlet kurumları ve kapandığı bilinen şirketler dışarıdaydı.
184 şirket geçti. Onları sırayla, iyi ve kötü siteleri, Arapça sürümü olan 100 şirkete ulaşana kadar kontrol ettik. Yüzüncü, Wamda’nın 30 Eylül 2025 tarihli makalesindeki DOO’ydu. Tüm kural, yazıyla birlikte yayımlanan örneklemin nasıl oluşturulduğu belgesinde yazılı.
O paragraftaki üç şey asıl işi yapıyor.
Kaynak sizin dışınızda. Şirketleri biz seçmedik. Wamda, yatırımlarını haberleştirerek seçti. Bu, seçimi benim elimden alır; ki yanıt hakkında zaten bir görüşüm olduğunda olması gereken yer orası.
Durma kuralı önceden konmuş. “Arapça sürümü olan 100’e ulaşana kadar” kontrol edebileceğiniz bir kural. “Yeterince olana kadar” değil.
Tanım yazılı. Arapça sürüm, bir ziyaretçinin şirketin kendi web sitesinden Arapça sayfa metnine ulaşabilmesi demek: bir dil anahtarı, bir hreflang Arapça bağlantısı, Arapça varsayılan ana sayfa ya da tarayıcı diline göre yönlendirme. Yalnızca mobil uygulamanın içinde var olan Arapça sayılmadı. Hiçbir şeyin bağlanmadığı bir Arapça URL de, sayfayı İngilizce bırakan bir dil anahtarı da. Bunlar yargı kararları ve tartışabileceğiniz yerde, notlarda duruyorlar.
Örneklemin kendisi düz bir dosya, sample.csv: şirket, ülke, sektör, ana sayfa, Arapça URL ve şirketi listeye sokan Wamda makalesi. 100 satır. Her satır, onu haklı kılan makaleye kadar izlenebilir.
Tarayıcı gerçekte neyi kontrol etti?
Tarayıcı tek bir dosya, scan.mjs. En üstteki yorum yaptığı her kontrolü listeler ve tüm çalışmanın üzerine kurulduğu kuralı belirtir: her kontrol ölçülür, asla tahmin edilmez.
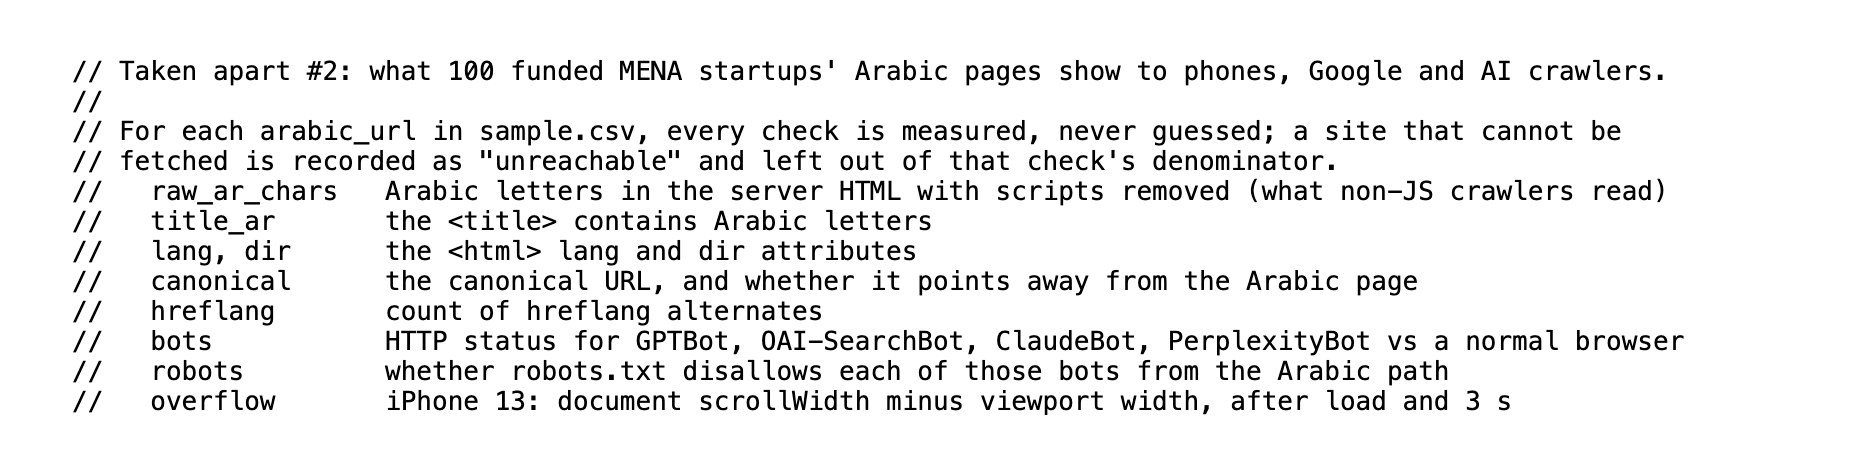
Her kontrol, sayfayı okuyan bir insanı ya da makineyi temsil eder.
| Kontrol | Ne okur | Kimi temsil eder |
|---|---|---|
| raw_ar_chars | Betikler çıkarılmış sunucu HTML’indeki Arapça harfler | JavaScript çalıştırmayan yapay zeka tarayıcıları |
| title_ar | Sayfa başlığının Arapça içerip içermediği | Google’daki mavi satırı okuyan Arapça arama yapan biri |
| lang, dir | Sayfada ayarlanan dil ve yön | Tarayıcılar, ekran okuyucular, arama motorları |
| canonical | Sayfanın kendini mi yoksa başka bir sayfayı mı orijinal olarak gösterdiği | Hangi sayfayı göstereceğine karar veren Google |
| hreflang | Sayfanın bildirdiği dil alternatiflerinin sayısı | Arapça ve İngilizce sayfaları eşleştiren Google |
| bots | GPTBot, OAI-SearchBot, ClaudeBot ve PerplexityBot için, normal bir tarayıcıya karşı HTTP durumu | ChatGPT, Claude ve Perplexity |
| robots | robots.txt’in bu botların her birini yasaklayıp yasaklamadığı | Sitenin kendi bildirdiği kurallar |
| overflow | Sayfanın yüklendikten sonra bir iPhone 13’te ne kadar yana kaydığı | Telefondaki bir insan |
Her getirme önce Arapça ister, yönlendirmeleri izler ve 25 saniye sonra vazgeçer. Telefon kontrolü sayfayı bir iPhone 13 görünüm alanında açar, yüklenmesini bekler, üç saniye daha bekler ve sayfanın ekrandan ne kadar geniş olduğunu ölçer.
En çok önemsediğim tasarım kararı, en küçük görüneni. Getirilemeyen bir site ulaşılamaz olarak kaydedilir ve o kontrolün paydasından çıkarılır. Bozuk sayılmaz, iyi de sayılmaz. Bilinmeyen sayılır ve bilinmeyenler bildirilir.
O tek kural, yazının “100’ün” yerine “tamamını okuyabildiğimiz 88 Arapça sayfadan” diyebilmesinin nedeni. Beş site o gün tarayıcıya hiçbir sayfa vermedi; dördü reddetti, biri yüklenemedi, bu yüzden sayfa kontrollerinin dışında. Her biri örneklem kontrol edildiğinde Arapça yüklenmişti, içeride kalmaları bu yüzden. Yedisi daha metin kontrollerinin dışında: yazının adlarını andığı, adresi dille değişmeyen altısı ve Arapçasını bir canvas üzerine çizen, yani okunacak metin olmayan biri. Tabanlar küçülür ve her sayı hangi tabanı kullandığını söyler: 179 şirket, 88 sayfa, tarayıcı kontrolleri için 94 sayfa ve telefon kontrolü için farklı bir 94.
Neden her sayı tabanını taşır?
Çünkü taban sayının kendisidir. Tabansız bir yüzde bir ruh hâlidir.
Çalışmadan gerçek bir örnek. Yazı, 179 şirketin 79’unun Arapça sürümü olmadığını söylüyor, yüzde 44. Aynı gün yayımlanan örneklem notları, 184’ün 79’unun Arapça sürümü olmayan çalışan bir web sitesi olduğunu söylüyor, yüzde 43. Aynı 79 şirket. İki farklı yüzde.
İkisi de doğru. 184, filtrelerden geçen her şirket. Bunlardan dördünün bulabildiğimiz bir web sitesi yoktu ve biri, sitesi bizi konumumuzdan engellediği için dışarıda bırakıldı; yani onun da ne olduğunu kontrol edemedik. O beşi çıkarırsanız yargılayabildiğimiz 179’u bulursunuz. 184’e bölmek, hiç yargılamadığımız beş şirketi tabanda tutar. 179’a bölmek yalnızca gördüğümüzü söyler.
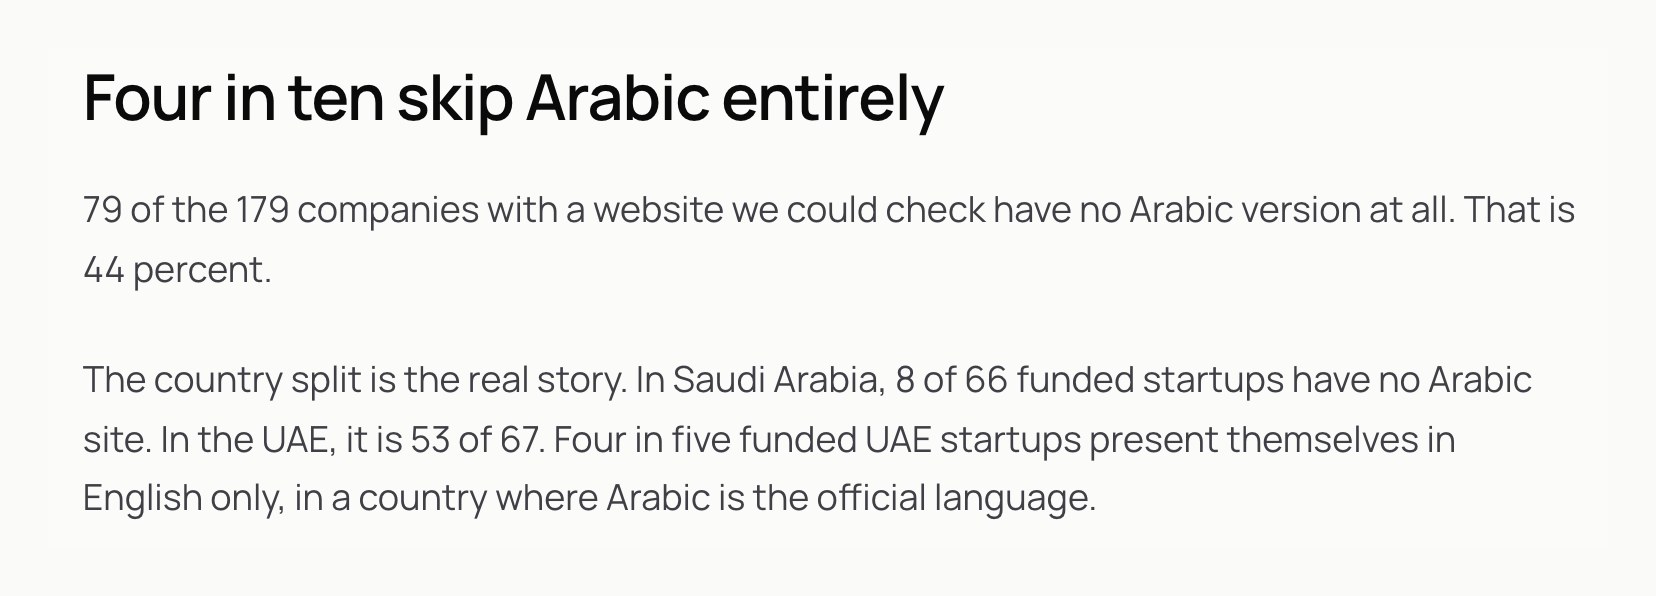
BAE ile de aynısı oluyor. Yazı 67’den 53 diyor. Örneklem notları 69’dan 53 diyor. Fark, bulabildiğimiz bir web sitesi olmayan iki BAE şirketi. Yine aynı 53, farklı taban, ikisi de doğru ve yalnızca biri web siteleri hakkında bir ifade.
“Yüzde 44”ü tek başına basmış olsaydık kimse iki farkı da fark etmezdi. Sorun tam da bu. Çıplak bir yüzde arkasındaki her kararı gizler. Taban, kararı okuyucunun tartışabileceği sayfaya geri koyar.
O yüzden buradan alınacak kural, araştırma raporları, panolar ve yatırımcı sunumları için aynı: önce sayıyı, sonra tabanı, sonra yüzdeyi yazın. “179’un 79’u, yüzde 44”. İlk ikisini dolduramıyorsanız üçüncüsüne sahip değilsiniz.
Örneklem sonuçla uyuşuyor mu?
Yayımlamadan önce iyi bir alışkanlık: yayımlanan dosyayı yayımlanan iddiaya karşı, bir yabancının yapacağı gibi kontrol etmek.
Yazı, yatırım almış 66 Suudi girişiminden 8’inin Arapça sitesi olmadığını, yani 58’inin olduğunu söylüyor. sample.csv’deki Suudi satırlarını sayın, 58 çıkar. 67 BAE girişiminden 53’ünün Arapça sitesi olmadığını, yani 14’ünün olduğunu söylüyor. Örneklemdeki BAE satırları: 14. Dosya ve yazı uyuşuyor ve herkes bir dakikada kontrol edebilir.
Örneklem, sayılanın şeklini de gösteriyor. 100 şirketin 28’i fintek, 22’si SaaS, 14’ü e-ticaret. 58’i Suudi. Bu verilerden “MENA girişimleri” hakkındaki her iddia aslında Suudi fintek ve yazılıma doğru ağırlıklı bir iddia. Sektör karması, o yıl para toplayıp haberleştirilenlerin karması. Suudi ağırlığı, örneklemin kendi kuralının iş başında hâli: liste yaklaşık o kadar BAE şirketi tutuyordu, Suudi kadar, 67 ve 66, ama örnekleme yalnızca Arapça sitesi olan bir şirket ulaşıyor. Bu yöntemin bir kusuru değil. Dosyada kimin olduğuna dair bir olgu ve okuyucunun örneklemin tüm bölgeye benzediğini varsaymasına izin vermek yerine yüksek sesle söylenir.
Dosyanın gösterdiği bir küçük şey daha: 100 satırın 32’sinde Arapça sayfa ile ana sayfa aynı adres. Bazen bu Arapça varsayılan bir ana sayfa. Bazen de kelimeleri değiştiren ve URL’yi koruyan bir dil anahtarı; sayımın metin kontrollerinin dışında bırakmak zorunda kaldığı durum. Dosya size hangisinin hangisi olduğunu söyleyemez. Siteyi açmanız gerekir.
Veri gerçekte ne buldu?
Tamamını okuyabildiğimiz 88 Arapça sayfanın 42’sinde, Arapçayı aramadan ya da yapay zeka yanıtlarından uzak tutan en az bir hata var. Bu yüzde 48.
- 28’inde hreflang yok, yüzde 32. Google Arapça ve İngilizce sayfaların iki dildeki aynı içerik olduğunu anlayamıyor. Google, hreflang’ın dil sürümlerini nasıl eşleştirdiğini yerelleştirilmiş sürümler belgesinde açıklıyor.
- 23’ü Arapça sayfada İngilizce sayfa başlığını koruyor, yüzde 26.
- 9’unda JavaScript çalışana kadar sayfada Arapça yok, yüzde 10. Ham sayfayı okuyan bir tarayıcı için o Arapça site boş.
- Tarayıcı kontrollerindeki 94 sayfanın 8’i bir yapay zeka tarayıcısını doğrudan bir hatayla reddediyor, yüzde 9. Sekizin yalnızca biri bunu robots.txt’te söylüyor.
- 3’ü Google’a orijinal olarak İngilizce sayfayı gösteriyor, yüzde 3.
İnsanların genellikle suçladığı mobil yerleşim büyük ölçüde sorunsuzdu. 94 sayfanın 4’ü bir iPhone’da yana kayıyor.
O son satır saymanın nedeni. Sayım, hataları başka bir yere koydu; kimsenin görmediği kısımlara: bir başlık etiketi, bir bağlantı öğesi, bir güvenlik duvarı kuralı. Veri analizi, nereye bakacağınız konusunda yanıldığınızı kanıtladığında en iyi hâlindedir.
Veri nerede durur?
Bir yapay zeka tarayıcısını reddeden sekiz siteye bakın. Veri kesin: tarayıcı sayfayı ister, sunucu bir hatayla yanıt verir, normal bir tarayıcı sayfayı alır. Ve sekizin yalnızca biri bunu robots.txt’te söylüyor.
Veri size bunu birinin seçip seçmediğini söyleyemez. Yazı, diğer yedisi için bunun kimsenin verdiği bir karar değil, bir güvenlik duvarı kuralı olduğunu söylüyor. Bu, kanıtın en makul okuması: bilerek verilen bir karar robots.txt’e gider, hiç bakılmamış bir varsayılan ise güvenlik duvarında durur. Ama yine de bir okuma. Durum kodu veridir. Arkasındaki niyet bir çıkarımdır ve onu olguya çevirmenin tek yolu şirkete sormaktır.
BAE sayısı da aynı. Yatırım almış 67 BAE girişiminden 53’ünün Arapça sitesi yok. Nedenlerini hayal edebilirsiniz. Alıcıları yabancı sakinler. Yatırımcıları İngilizce okuyor. Arapça yol haritasında. Biz hiç sormadık. Her biri farklı bir tasarım kararına götürür ve veri hepsine aynı satır gibi davranır.
NN/g’nin nitel ve nicel araştırma karşılaştırması bunu tek satırda söylüyor: nicel veri bir tasarımın işe yaramayabileceğini söyleyebilir, ama kullanıcıların hangi sorunlarla karşılaştığını göstermez ve neyin değişmesi gerektiğini söylemez. Yazının sınırı tam olarak bu. Bir teklifle bitiyor: “Arapça siteniz sayıların içindeyse ve hangileri olduğunu bilmek istiyorsanız, bana sorun”; çünkü bir sayımdan sonraki adım her zaman bir konuşmadır.
Kendi ürününüzdeki terki nasıl okursunuz?
Parçalarına ayırma taraması kamuya açık veri. Tasarımdaki veri analizinin çoğu kendi ürününüzün sayıları ve biçim aynı.
Böyle bir huni, terk verisinin en yaygın biçimi. Her adım kaç kişinin ona ulaştığını listeler. Sayının en sert düştüğü adım, önce baktığınız yerdir.
Ben bunu şöyle yürütüyorum.
- Panoyu açmadan önce soruyu yazın. “Satıcıların müşterileri sepet ile ödeme arasında nerede ayrılıyor?” bir sorudur. “Analitiğe bakalım” bir öğleden sonrayı kaybetmenin yoludur.
- Pencereyi ve kaynağı sabitleyin. Bakmadan önce seçilmiş tek bir tarih aralığı, tek bir veri kaynağı. Grafik ilginç görünene kadar aralığı değiştirmek, zaten tanıdığınız yirmi siteyi seçmenin pano sürümüdür.
- Her adım için sayıyı ve tabanı yazın. “Ödeme kötü” değil. “Bu ay ödemeye ulaşanlardan şu kadarı ödedi.”
- En büyük düşüşü bulun, her düşüşü değil. Her huni her adımda sızdırır. Çalışılacak olan, en çok insanın ayrıldığı adım.
- Arkasındaki ham satırları okuyun. O adımdan gerçek oturumları, gerçek siparişleri, gerçek talepleri açın. Ortalamalar üç kez deneyen kişiyi gizler.
- Durun ve görüşme sorularını yazın. Veri analizinin çıktısı bir düzeltme değildir. Konuşulacak insanların ve onlara ne soracağınızın kısa bir listesidir.
Altıncı adım, insanların atladığı adım. Huni, birçok insanın ödemede ayrıldığını söylüyor. Teslimat ücretinin onları şaşırtıp şaşırtmadığını, ödeme yönteminin eksik olup olmadığını, sayfanın yanlış dilde olup olmadığını ya da yalnızca fiyat karşılaştırıp karşılaştırmadıklarını söylemiyor. Bunların her biri farklı bir ekran. Sormadan birini seçerseniz, kendi tahmininiz için tasarlıyorsunuz ve bir grafik onu araştırma gibi gösteriyor.
Nedeni ne yapmalı?
Gidip insanlardan almalı.
Körfez’deki koyun ve keçi yetiştiricileri için tasarladığımız uygulama Wfrah’ta yetiştiriciler yüksek sesle aynı yanıtı verdi: yem pahalı ve alıcılar az ödüyor. Yalnızca insanların söylediğini sayarsanız bulgunuz bu olurdu. Görüşmeler altta ne olduğunu gösterdi. Birçok yetiştirici sürünün günlük beslenmesini denklemlerle hesaplayamıyordu ve suçu piyasaya atmak beslenmeyi ve yönetimi gözden kaçırmayı kolaylaştırıyordu. Bu yüzden uygulama, hesabı onlar için yapan bir beslenme hesaplayıcısı taşıyor.
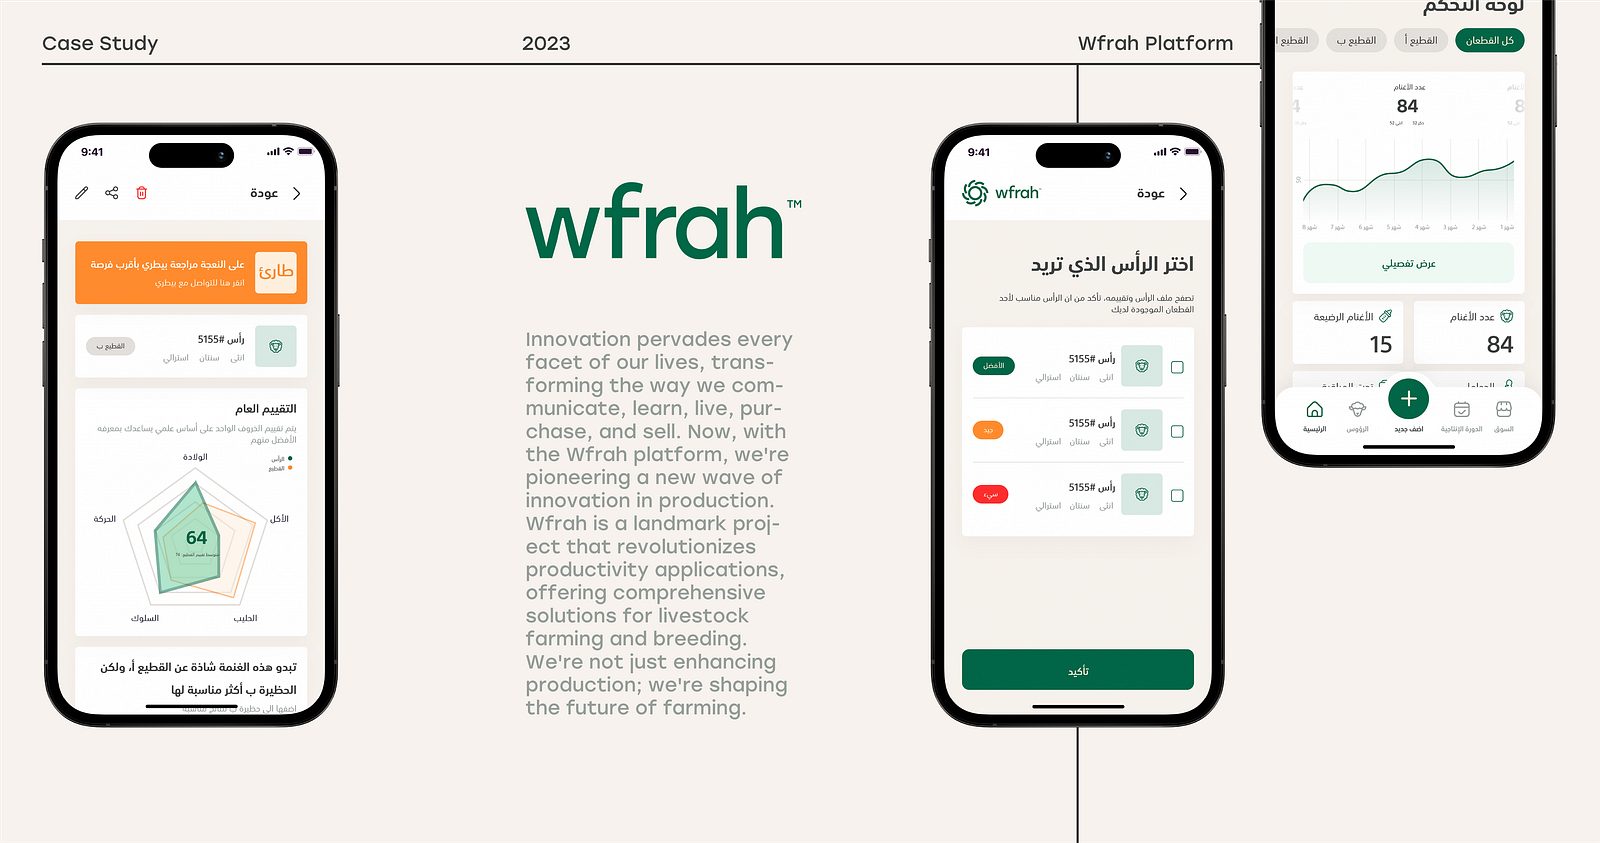
Çalışma sırası basit. Veri analizi nerede olduğunu bulur ve boyutlandırır. Görüşmeler nedeni bulur. Veriden kurulan bir kullanıcı görüşmesi betiği, kişinin tam o adıma en son çarptığı zamanı sorar. Bir benzerlik haritası söylediklerini sıralar, her notta bir katılımcı etiketiyle; böylece her temayı bir insana kadar izleyebilirsiniz. Sonra bir sorun tanımı, neyi düzelttiğinizi ve kimin için olduğunu, boyutun kanıtı olarak verinizdeki sayımla birlikte söyler.
Kendinizi kandırmadan veri analizinde yapay zekayı nasıl kullanırsınız?
Yapay zeka bu yöntemi çok ucuzlattı. Bir model bir dakikada bin uygulama yorumunu okur, destek taleplerini temalara ayırır, kazıyıcıyı yazar ve raporu taslaklar. Araçlar hızla ilerliyor. Kodlama ajanları için bir veri analizi araç seti olan Graphene’in Ekim 2026 tarihli Show HN paylaşımı açık soruyu net koydu. Yapımcılar, bir kodlama ajanının artık bir BI ekibinin işinin çoğunu yapıp yapamayacağını sordu ve yanıtladı: neredeyse. Bir bağlam katmanına “sorgu doğruluğunu sağlamak için” ihtiyaçları var.
Oyunun tamamı doğruluk. Sorguyu biraz yanlış alan bir model yine de kendinden emin bir grafik döndürür. Araştırmayı özetlemesi istenen bir model, “kullanıcıların çoğu” ya da hiçbir yerden gelmeyen yuvarlak bir yüzdeyi seve seve yazar. Çıktı bitmiş görünür ve bitmiş görünmek doğru olmakla aynı şey değildir.
Parçalarına ayırmayı dürüst tutan daha zeki bir model değildi. İşi kontrol edilebilir kılan bir kurallar kümesiydi ve bunlar bir yapay zekanın dokunduğu her analiz için geçerli.
Ona sonuç değil kod yazdırın. Tarayıcı, sayfaları getiren ve gördüğünü kaydeden bir dosya. Hiçbir şeye karar vermez. Modelden sayan betiği isteyin, sonra kendiniz çalıştırın. Bir betik yeniden okunabilir ve yeniden çalıştırılabilir. Bir paragraf olmaz.
Bilinmeyenleri kaydettirin. “Ölçülür, asla tahmin edilmez” tarayıcının ilk satırlarında bir nedenle duruyor. Bir model eksik bir değeri olası bir değerle doldurursa sonucunuz kısmen veri, kısmen kurgu olur ve hangisinin hangisi olduğunu söyleyemezsiniz.
Her sayı için tabanı isteyin. Yapay zekanın yazdığı bir özetteki her yüzdeye iki soru sorulur: kaçın içinde ve hangi dosya. İkisini de yanıtlayamıyorsa silin. İyi duyulan sayılar için istisna yok.
Ham satırları kendiniz açın. Bir temaya güvenmeden önce içindeki beş gerçek yorumu okuyun. Bir sayıma güvenmeden önce saydığı sitelerden üçünü açın. Parçalarına ayırma örneklemi bu sınavı geçiyor: CSV’deki Suudi ve BAE sayımları yazıyla uyuşuyor.
Sırayı ve durma kuralını modelin dışında tutun. Model hangi kayıtların okunacağına ya da ne zaman duracağına karar vermemeli. Elverişli bir sonucun içeri sızması en kolay yer orası ve sahip olduğunuz bir karar.
Sayıyı yayımlıyorsanız yöntemi de yayımlayın. Tarayıcı, örneklem ve örnekleme notları yazının yanında duruyor. Bu, var olan en güçlü kontrol. Bir şeyi yanlış yaptıysam, herkes bulabilir.
Bunun öbür yarısını yapay zeka kullanıcı araştırmasının yerini alabilir mi yazısında anlattım: bir model taslaklamada, sıralamada ve listelemede iyi, kullanıcınız olmada kötü. Veri analizi onun en yararlı ve en tehlikeli olduğu yer; çünkü çıktı sayılar ve insanlar sayılara okumadan güveniyor.
Veriyle ne zaman başlamamalısınız?
Okunacak henüz bir şey yokken ya da elinizdeki veri yanlış şeyi sayarken.
Ürünü olmayan yeni bir fikrin analiz edilecek oturumu yoktur. Kamuya açık veriler yine de yardımcı olabilir: rakiplerin siteleri, en yakın ürünün yorumları, insanların forumlarda kullandığı dil. Ama ana araştırma görüşmelerdir ve var olmayan sayıları beklememelisiniz.
Altı anket yanıtı bir ipucudur, bulgu değil. Ondalığa kadar ortalama hesaplayıp sonuç diye sunmayın. Ne önerdiklerini söyleyin ve gidip sorun.
Bir metrik yanlış sonucu izliyor olabilir. Bir sayfa kafa karıştırdığında tıklamalar, sayfada geçirilen süre ve oturumlar yükselebilir. Veriniz yanlış davranışı ödüllendiriyorsa daha fazla analiz sorunu daha kesin gösterir. Önce kullanıcının neyi yapmaya çalıştığına karar verin, sonra onu izleyen sayıyı seçin.
Nüfus, araçlarınızın iyi okumadığı bir dilde yazıyor olabilir. Lehçeli, karışık yazılı ve harflerle yazılmış İngilizce içeren Arapça yorumlar araçların sıralaması için zordur ve yorumları kendiniz okumadıkça hataları görmezsiniz. Parçalarına ayırmanın bir makinenin tam okuduğu şeyleri, Arapça harfleri ve durum kodlarını saymasının ve anlamı bir modelin tahmin etmesini gerektiren her şeyden kaçınmasının nedenlerinden biri bu.
Bir sonraki sefer bu neye benzer?
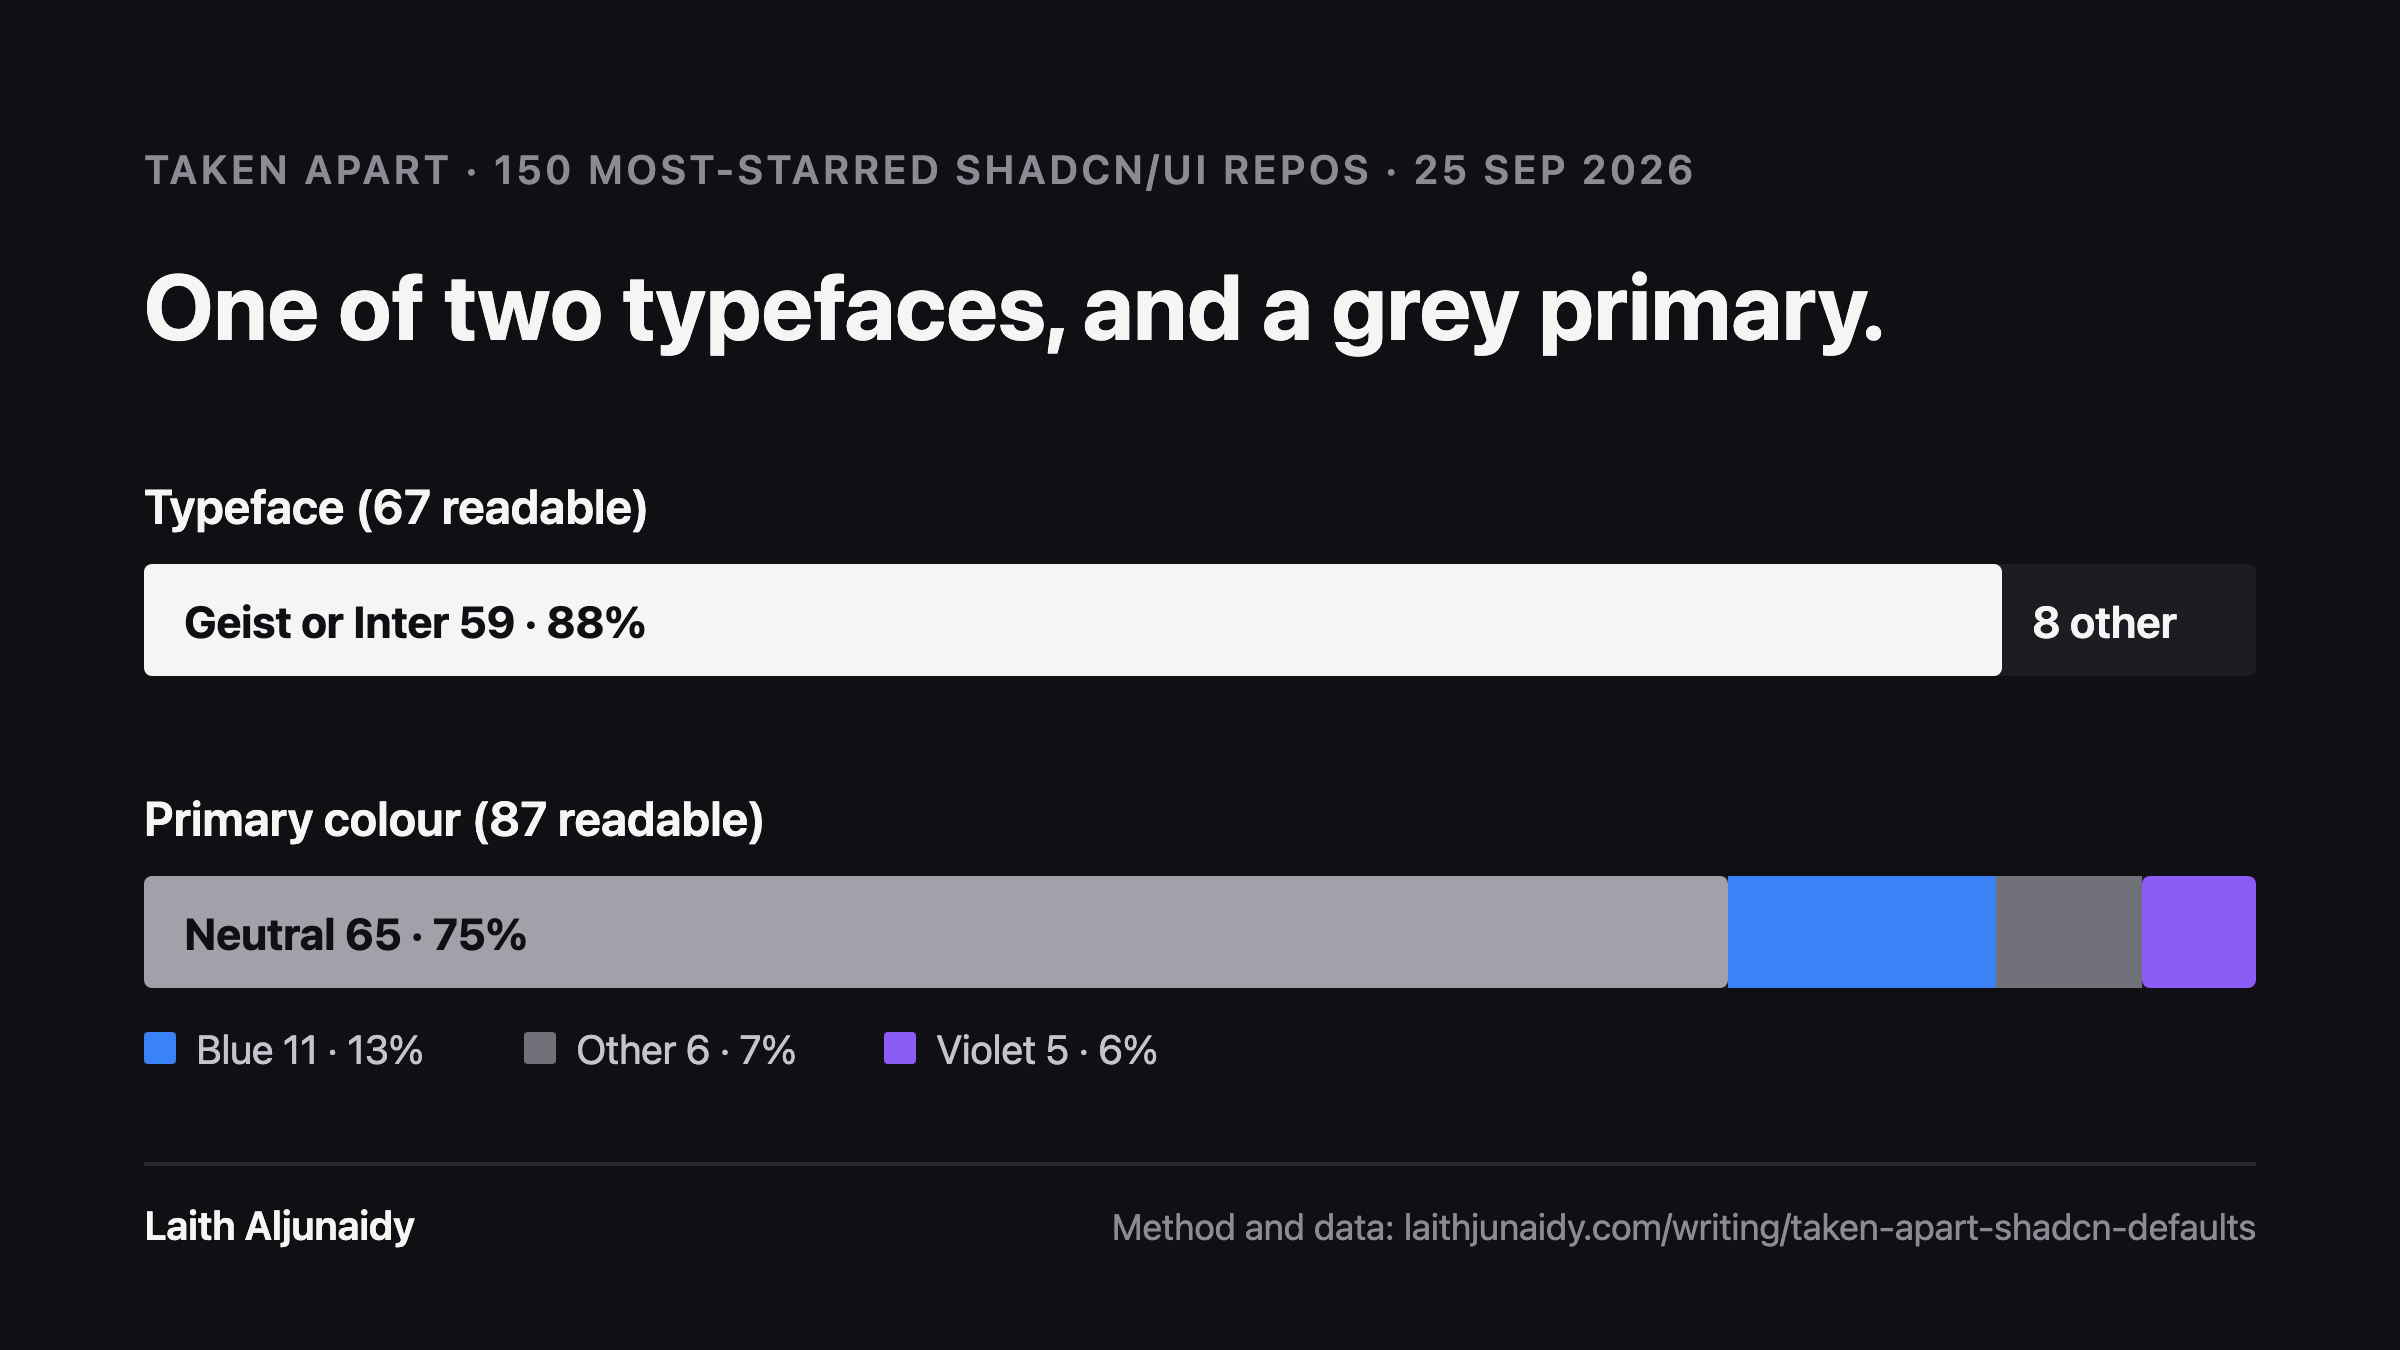
Aynı yöntem her ölçekte işler. Parçalarına ayırdık, birinci sayı web siteleri yerine GitHub’da yürüdü: en çok yıldızlı 150 shadcn/ui deposu, yazı tipi ve birincil renk koddan okunarak. Sinyalin okunamadığı bir depo okunamaz sayıldı, asla tahmin edilmedi ve bu, okunabilir yazı tipi olan 67’yi bıraktı. O 67’nin 59’u Geist ya da Inter kullanıyor. Aynı kurallar, farklı kaynak.
Kendi sürümünüzü yürütmek istiyorsanız sıra şu:
- Bir sayımla yanıtlayabileceğiniz bir soru.
- Sabit bir sırayla okunan tek bir kaynak ve neyin nitelikli sayılacağına dair yazılı kurallar.
- Önceden belirlenmiş bir durma kuralı.
- İlk kayıttan önce yazılmış tanımlar.
- Ölçen ve bilinmeyenleri kaydeden bir tarayıcı ya da sorgu.
- Her sonuç sayı, taban, yüzde olarak.
- Yayımlanan dosyanın yayımlanan iddiaya karşı kontrolü.
- Yöntem ve örneklemin sayının yanında yayımlanması.
- Şimdi nedenini sormanız gereken insanların bir listesi.
Son adım, analizi tasarıma çeviren adım. Sayım, yatırım almış 67 BAE girişiminden 53’ünün yalnızca İngilizce olduğunu söylüyor. Erişim ya da kimseden izin gerektirmedi. Nedenini bulmak konuşmalar gerektirecek ve neden, herkesin ne inşa etmesi gerektiğine karar verecek.
Sıkça sorulan sorular
UX’te veri analizi nedir?
Yeni bir şeyi araştırmadan ya da tasarlamadan önce var olanı okumak: analitik, huniler, satış, destek talepleri, arama kayıtları, uygulama yorumları ve kamuya açık veriler. İnsanların nerede ayrıldığını ve kaç kişinin etkilendiğini gösterir. En ucuz araştırma yöntemi, bu yüzden önce gelir ve bir düzeltmeyle değil, görüşme soruları ile biter.
Veri analizi ile ikincil araştırma arasındaki fark nedir?
Örtüşürler. İkincil araştırma, ya da masabaşı araştırma, başkalarının zaten bulduklarını toplamaktır: raporlar, çalışmalar, eski araştırmalar. Veri analizi, ham kayıtları kendiniz okumak, kendi ürününüzün sayılarını ya da kamuya açık verileri, ve bir şeyi saymaktır. Parçalarına ayırma, kamuya açık veriler üzerinde veri analiziydi: sırayla okunan tek bir yatırım akışı ve 100 şirketin Arapça sayfalarının bir tarayıcıyla kontrol edilmesi.
Veri kullanıcıların neden ayrıldığını söyleyebilir mi?
Hayır. Veri insanların nerede ayrıldığını ve kaç kişi olduklarını gösterir. Ne yapmaya çalıştıklarını, neyin kafalarını karıştırdığını ya da ne beklediklerini gösteremez. NN/g de aynı noktayı yapıyor: nicel veri bir şeyin işe yaramadığını söyleyebilir, ama kullanıcıların hangi sorunlarla karşılaştığını ya da neyin değişmesi gerektiğini söylemez. Veriyi, kiminle görüşeceğinizi ve ne soracağınızı seçmek için kullanın.
Yapay zekayla müşteri geri bildirimini nasıl analiz edersiniz?
Modele ham geri bildirimi verin, her öğenin kaynağına etiketlendiği temalar isteyin ve tabanlarıyla birlikte sayımlar isteyin. Sonra her temadan beş gerçek öğeyi kendiniz okuyun, arkasında sayım ve dosya olmayan her yüzdeyi silin ve sonucu görüşmeler için sorular olarak ele alın. Yapay zeka sıralamada hızlı. Bir doğruluk kaynağı değil.
Bir örneklem ne kadar büyük olmalı?
Soru için yeterince büyük ve bakmadan önce karar verilmiş. Parçalarına ayırma kuralını önceden koydu: Arapça sürümü olan 100 şirkete ulaşana kadar nitelikli her şirketi sırayla kontrol etmek; bu 184 şirket demekti. Altı anket yanıtı gibi küçük bir örneklem yine de yararlı olabilir, insanlarla konuşmaya gitmek için bir neden olarak, kendi başına bir bulgu olarak asla.
Tarayıcıyı ve örneklemi neden yayımlıyorsunuz?
Çünkü kimsenin kontrol edemeyeceği bir sayı bir iddiadır, bulgu değil. scan.mjs, sample.csv ve örneklemin nasıl oluşturulduğu belgesini yayımlamak, herkesin çalışmayı yeniden yürütmesini, bir hata bulmasını ya da genişletmesini sağlar. Şirket başına sonuçlar özel kaldı. Amaç isim listesi değil, örüntüydü.
Kaynaklar
- ikincil araştırma nngroup.com
- yatırım haberleri wamda.com
- yerelleştirilmiş sürümler developers.google.com
- NN/g’nin nitel ve nicel araştırma karşılaştırması nngroup.com
- Show HN news.ycombinator.com